ホームサービスデータ活用・データインテリジェンス
SERVICE · DATA INTELLIGENCE

データ活用・データインテリジェンス

エンタープライズ向けシステムインテグレーターのCubastionは、データ活用の基盤づくりを支援します。部門やシステムごとに分散したデータを整理・クレンジングして一つに統合し、BI・分析・予測へつなげます。「データはあるのに、どう整理し、どう使えばよいか分からない」状態を、動く仕組みに変えます。

対応する領域
データ統合 データクレンジング データエンジニアリング BI・可視化 分析・予測 MLOps データ移行 データ品質
データ統合の実績
59システム
顧客データ一元化
55%
データ誤り削減
4,500万件
重複排除後に統合
BASICS

データ活用とは

データ活用とは、社内外に蓄積されたデータを集めて整え、可視化・分析・予測に使うことで、業務や経営の判断を変えていく取り組みです。データ利活用とも呼ばれます。

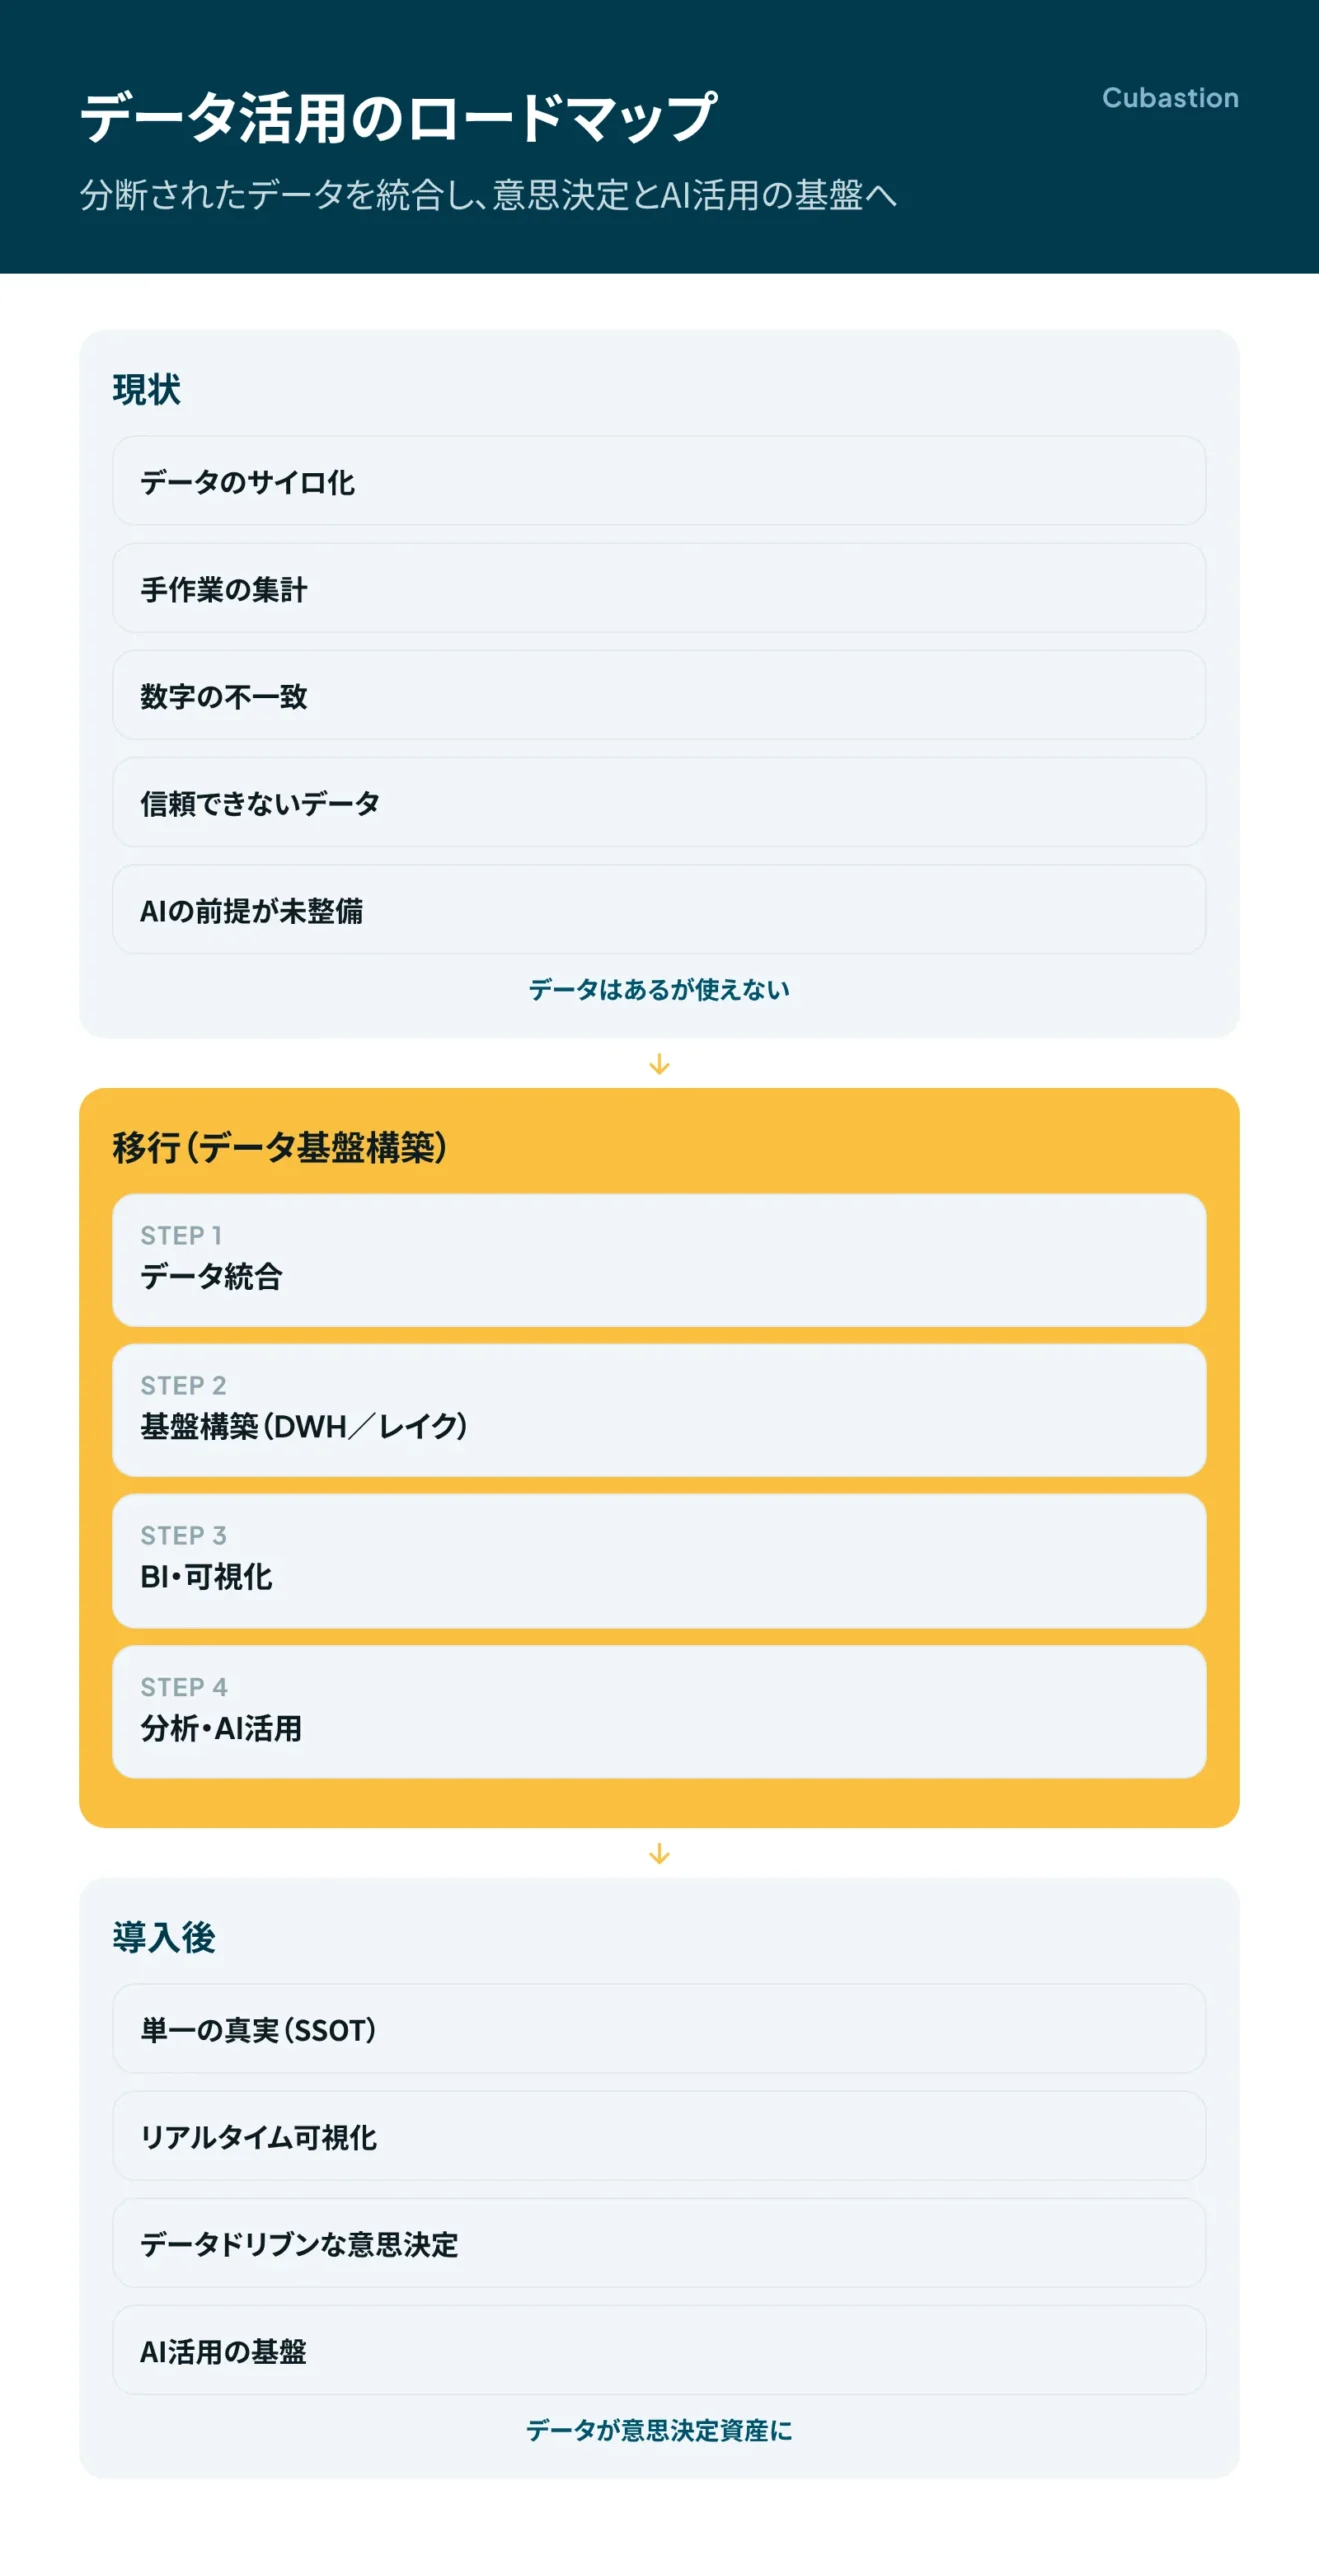
多くの企業では、データそのものは十分にあります。課題は、ERP・会計・販売・Excelなどにデータがサイロ化し、定義や品質がそろっていないことです。この状態では、BIで可視化しても数字が合わず、AIに使っても精度が出ません。

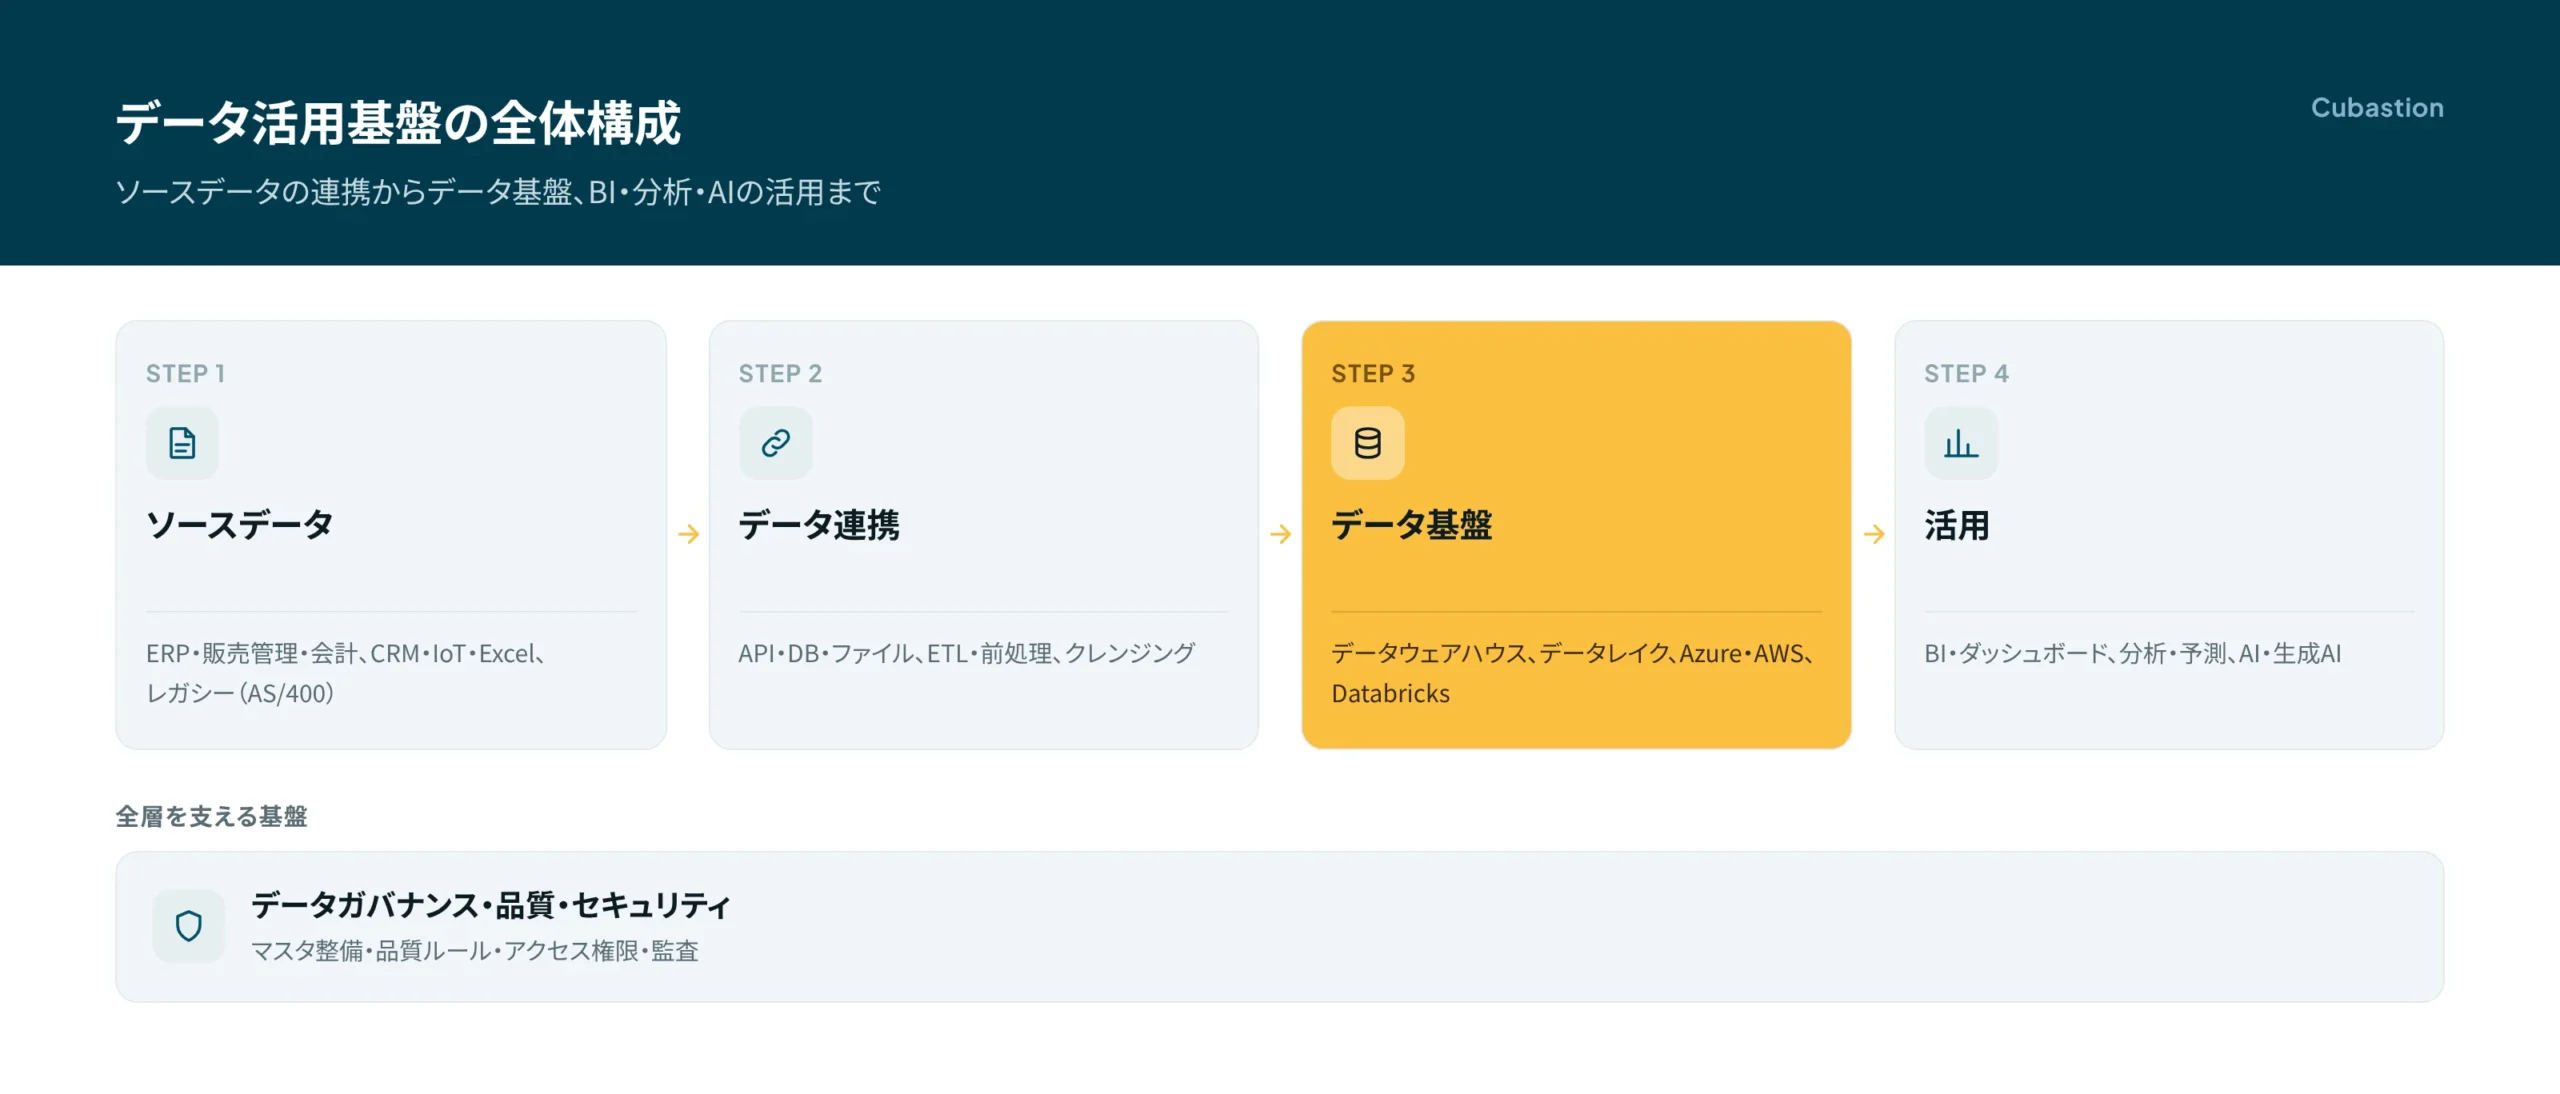
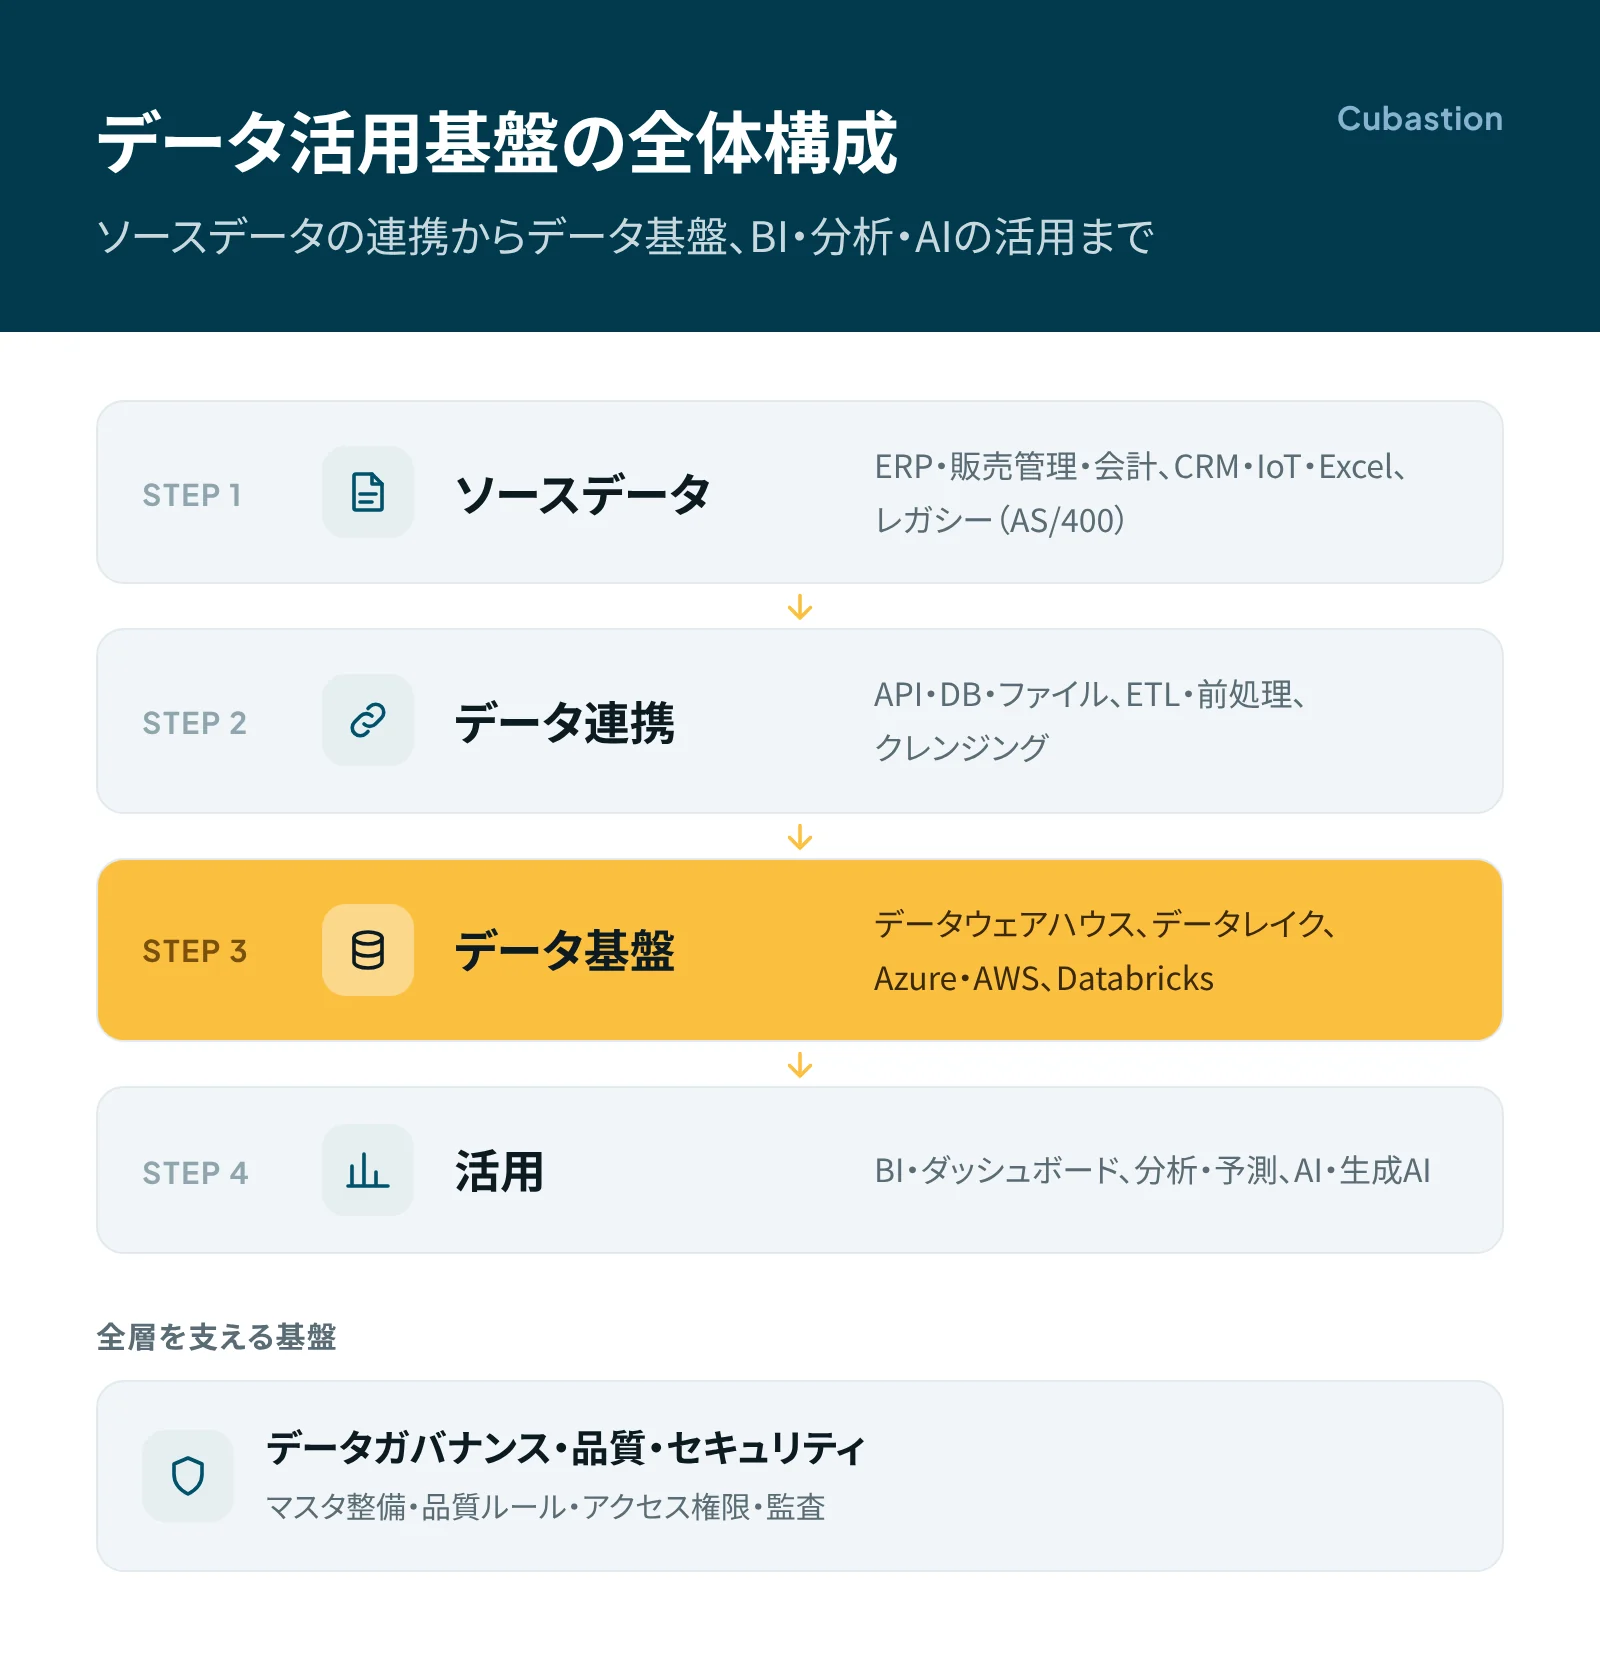
そのためデータ活用は、データ分析基盤の整備から始まります。データエンジニアリングでデータを統合し、品質と権限を管理したうえで、BI・分析・予測、さらに生成AIへと段階的に広げていきます。

STEP 1
データ統合
分断されたデータをつなぐ
STEP 2
データ品質の管理
定義・マスタ・権限をそろえる
STEP 3
BI・可視化
判断に使える形で見せる
STEP 4
分析・予測・AI
需要予測・異常検知・生成AI
CHALLENGES

データ活用を阻む4つの壁

それぞれのシステムが個別に作られ、つながっていないために、データは分断されたまま眠っています。データ活用を進めるうえで、多くの企業が次の4つの壁に直面します。

01

データサイロによる分断

受発注・在庫・会計・顧客のデータが、システムごとに分断されたデータサイロの状態。

02

データ品質のばらつき

同じ「売上」でも、部門によって数字が異なる。

03

意思決定に届かない

見たい形で可視化されず、現場や経営の判断が変わらない。

04

AI・分析の前提が未整備

生成AI・需要予測・異常検知は、整備されたデータがあって初めて成立。

使えないデータのコスト
約80%
日本企業のIT投資のうち既存システムの維持運用に充てられる割合(IPA「DX白書」)
最大 年約12兆円
2025年以降に生じうる経済損失(経済産業省「DXレポート」2018年)
OUR STRENGTH

データサイロの解消とデータ統合

展示会や商談で最も多く伺うのが、「データはあるが、部門ごとのシステムに分散していて、どう整理し、どう使えばよいか分からない」というご相談です。データサイロとは、このようにシステムや部門ごとにデータが分断され、横断的に使えない状態を指します。

分散したデータの整理・クレンジング・統合は、Cubastionが数多くのプロジェクトで実績を重ねてきた得意領域です。次の3つの段階で、使えるデータに整えます。

01

データの棚卸し

どのシステムに、どんなデータが、どの定義で入っているかを洗い出し、重複や不整合の範囲を把握します。

02

整理・データクレンジング

重複の排除、欠損の補完、表記ゆれの統一を行い、判断に使える品質のデータに整えます。

03

一つの基盤への統合

ETLとデータウェアハウス/データレイクで分散したデータをつなぎ、BI・分析・予測から一つの基盤として参照できるようにします。

データ統合の実績
8,500万件→4,500万件
6つのプラットフォームに分散した顧客レコードを重複排除・統合(Hyundai ICDB)
59システム
分断されたB2B顧客データを一元化(Airtel)
55%
統合による顧客データの誤りの削減(Airtel)
SERVICES

データ活用を支えるサービス

データ統合からBI・分析・予測、移行、データ品質の管理まで。必要な領域から組み合わせてご提供します。

01

データ統合・データ基盤(データエンジニアリング)

API・DB・ファイル、AS/400を含むレガシーのデータソースを統合。

ETLデータウェアハウスデータレイクAzure/AWS
02

BI・可視化・ダッシュボード

KPIや業務状況を可視化。Single Source of Truthを実現。

Power BITableau
03

データ分析・予測(アナリティクス)

記述分析から予測・最適化まで。機械学習モデルを本番で運用。

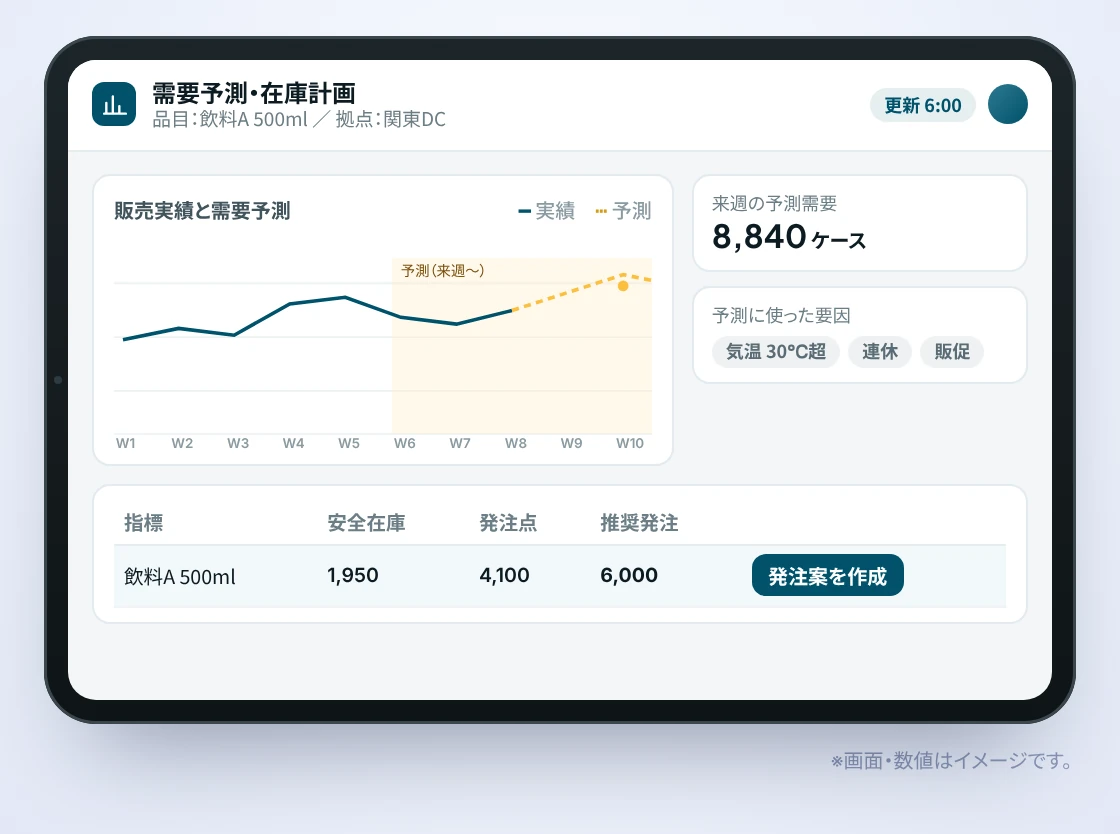
需要予測異常検知機械学習生成AI
04

データ移行・モダナイゼーション

レガシーシステムやCRMからの大規模データ移行とデータクレンジング。

大規模移行データクレンジング
05

データ品質・セキュリティ

マスタ整備、品質ルール、アクセス権限、監査。

マスタ整備品質ルールアクセス権限監査
分散したソースデータを連携・統合し、データ分析基盤からBI・分析・予測・生成AIへ活用する構成です。

データ活用のご相談

まずは、データ活用の現在地から。データアセスメントで分断状況・品質・活用度を整理します。

OUR APPROACH

データ統合とデータ分析基盤の構築

分散したデータをデータ統合で一つの基盤にまとめ、データ分析基盤を先に整えたうえで、分析・予測・生成AIを載せていきます。構築にあたっての方針は次の4つです。

01

基盤ファースト

AIの前に、まず使えるデータ基盤を整える。

02

スモールスタート

特定の業務・レポートから着手し、効果を確認しながら対象を広げる。

03

ツールに依存しない設計

お客様の環境と目的に合った技術を選ぶ。

Power BITableauDatabricksInformatica
04

AIまで見据えた設計

将来の生成AI・予測・分析を見据え、再加工が不要な基盤を設計する。

データ品質の管理

統合したデータも、定義や値がそろっていなければ判断には使えません。重複・欠損・表記ゆれを品質ルールで検出し、継続的に管理します。

マスタ整備と品質ルールで「部門ごとに数字が違う」状態をなくし、アクセス権限と監査で安全な利用を担保します。

MLOpsによる予測モデルの本番運用

MLOpsとは、機械学習モデルの開発・デプロイ・監視・再学習を継続的に回すための運用の仕組みです。

データレイクからAI基盤まで一貫して設計し、需要予測や異常検知のモデルを本番で使い続けられる状態にします。

SOLUTIONS

AI・予測への展開

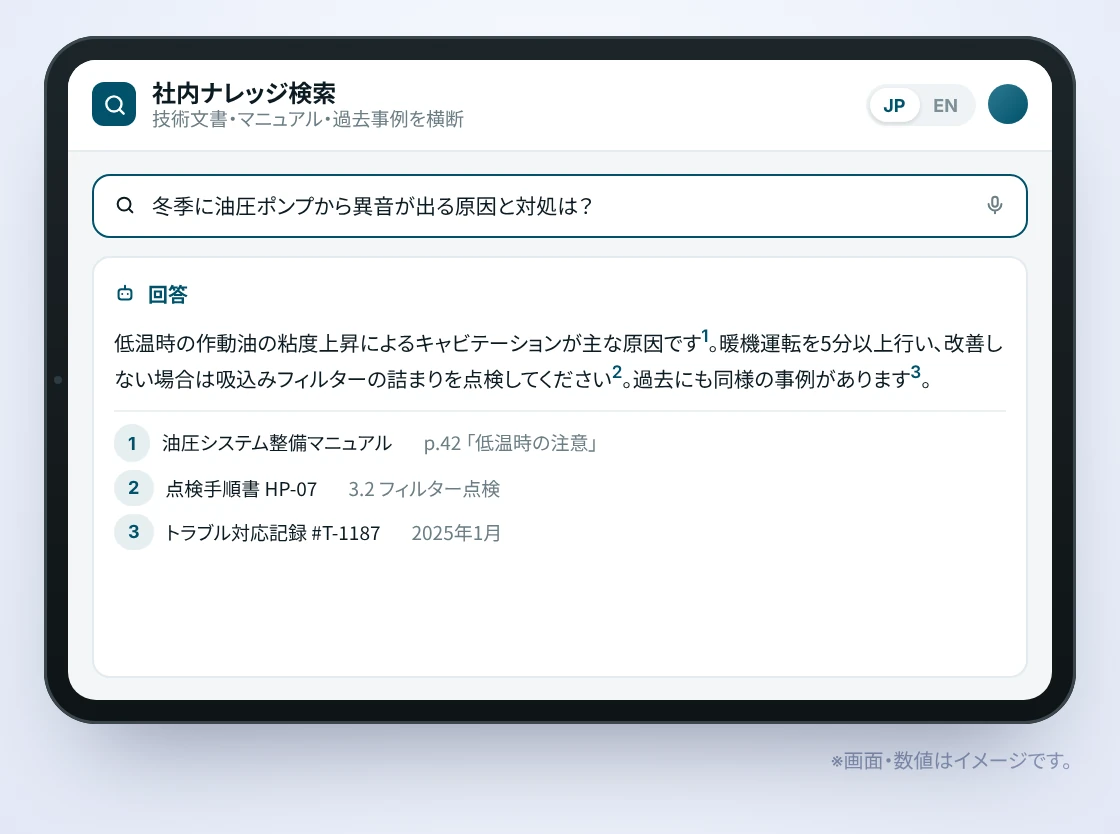
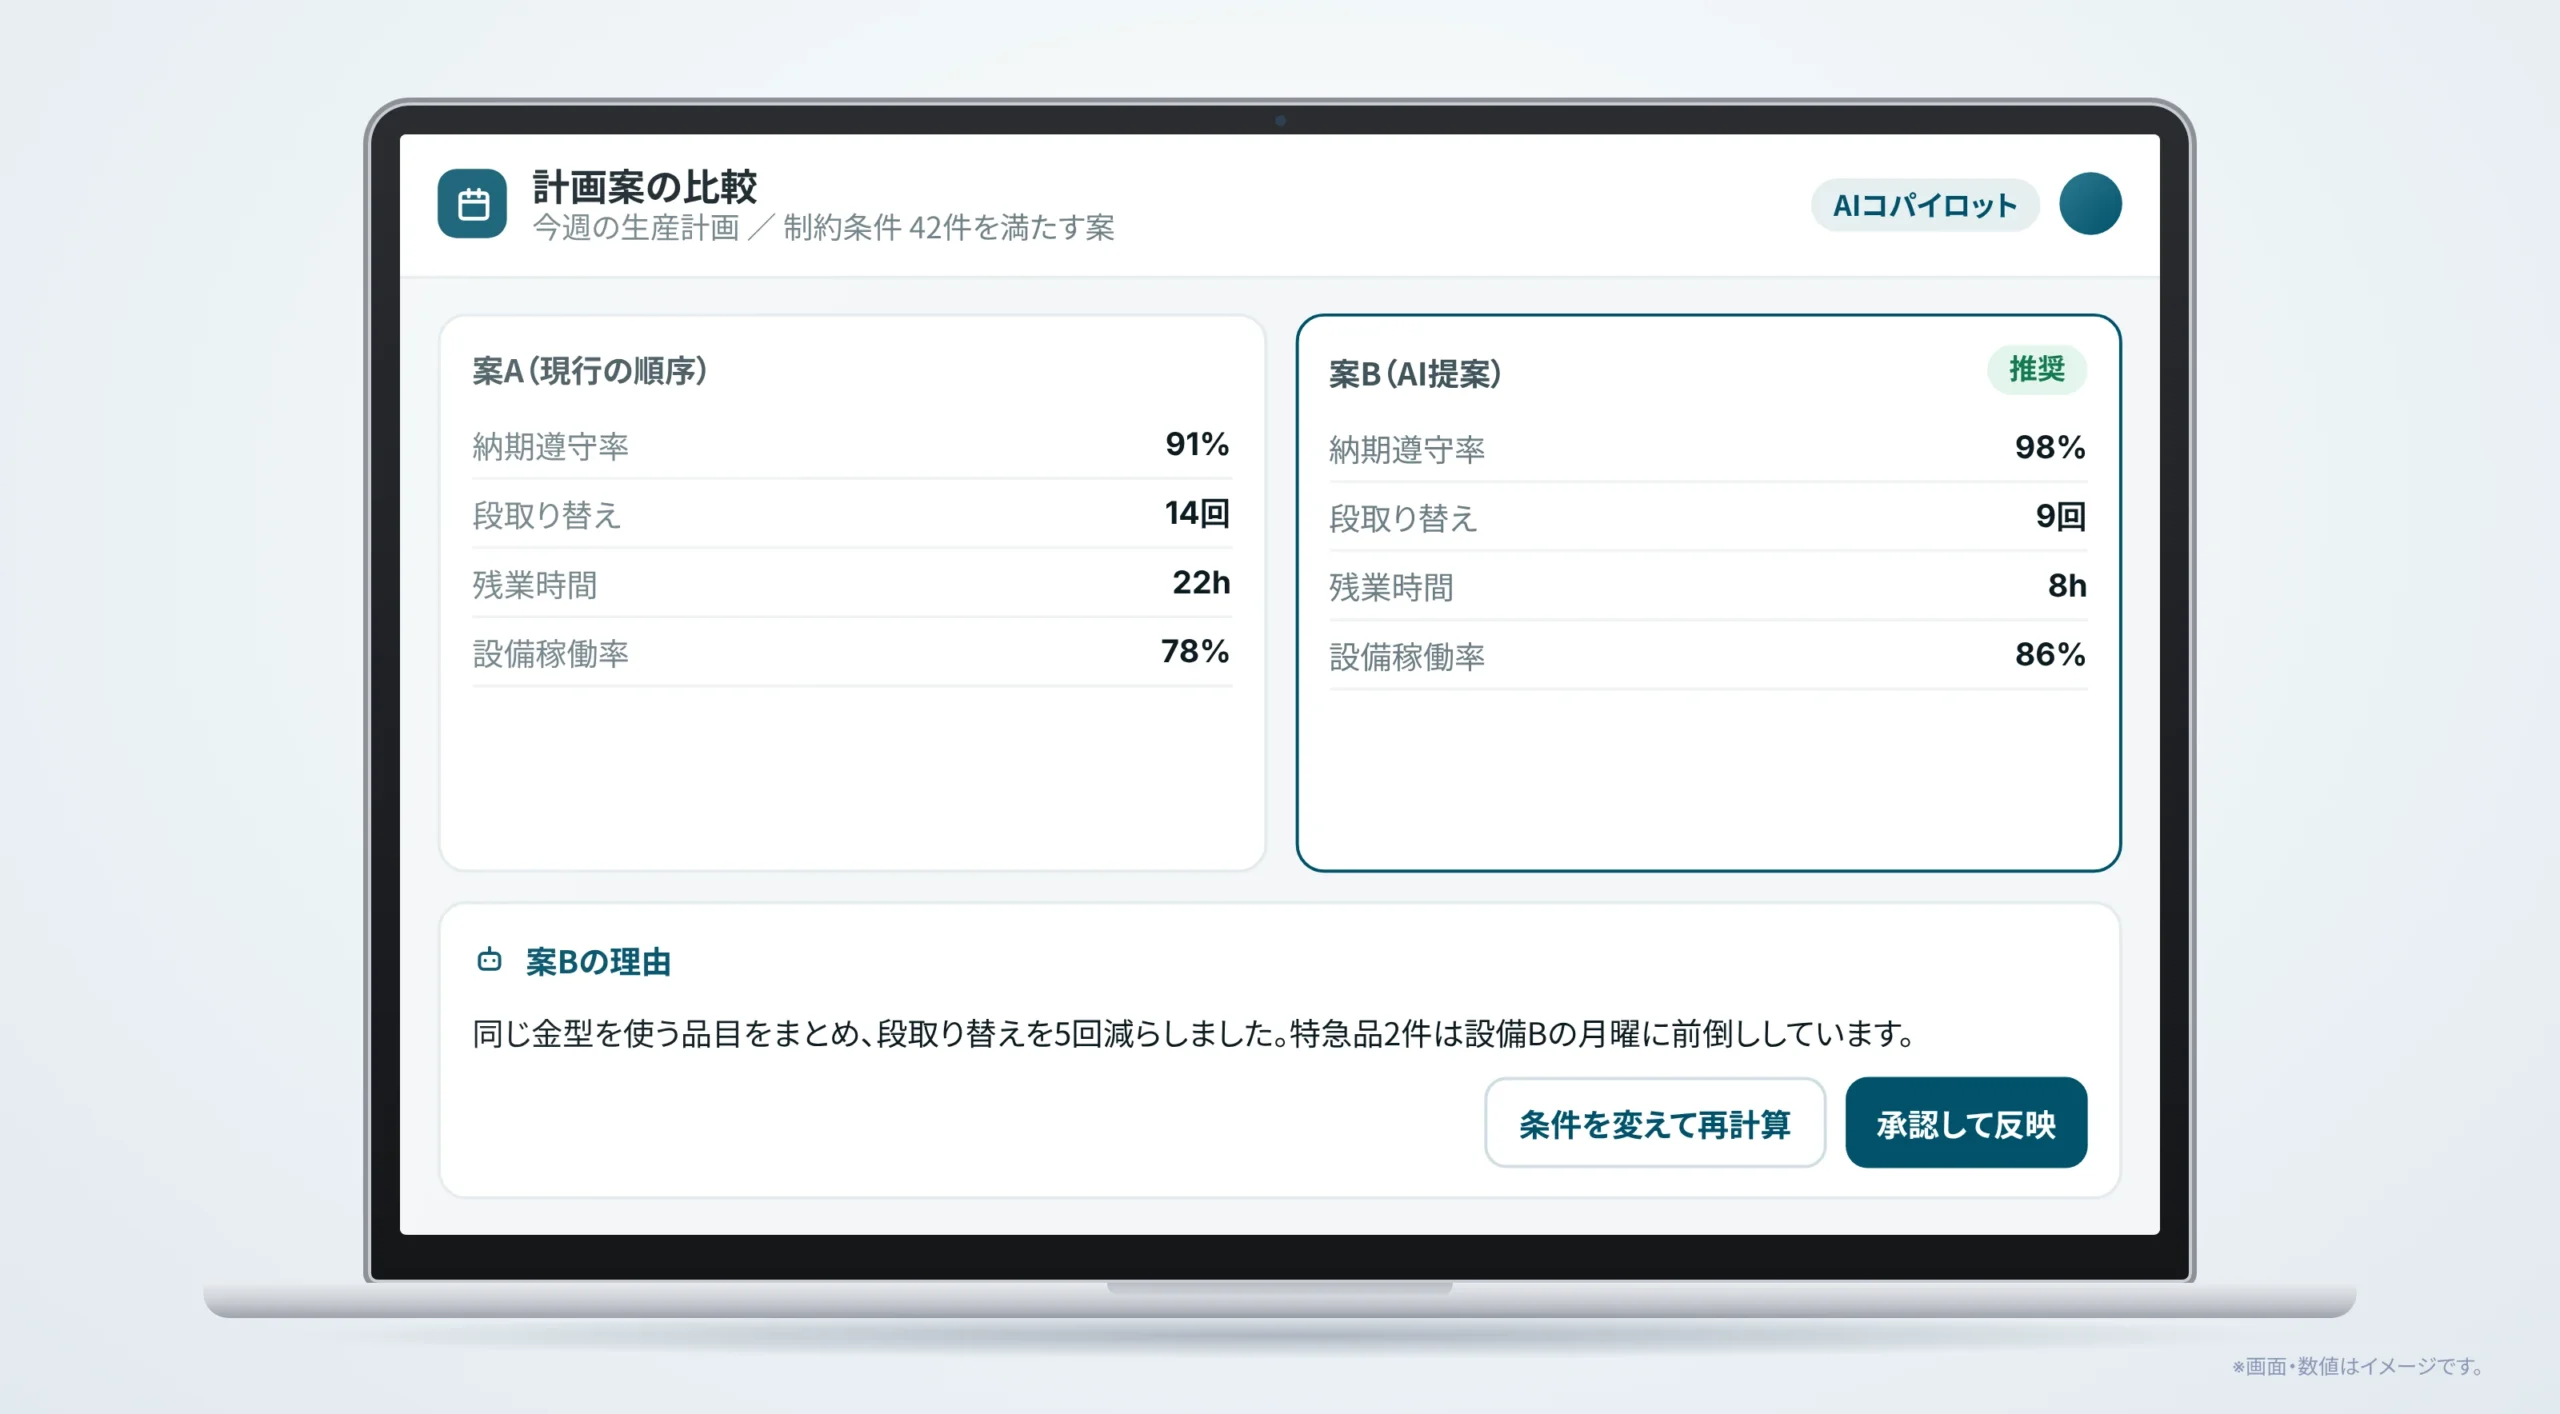
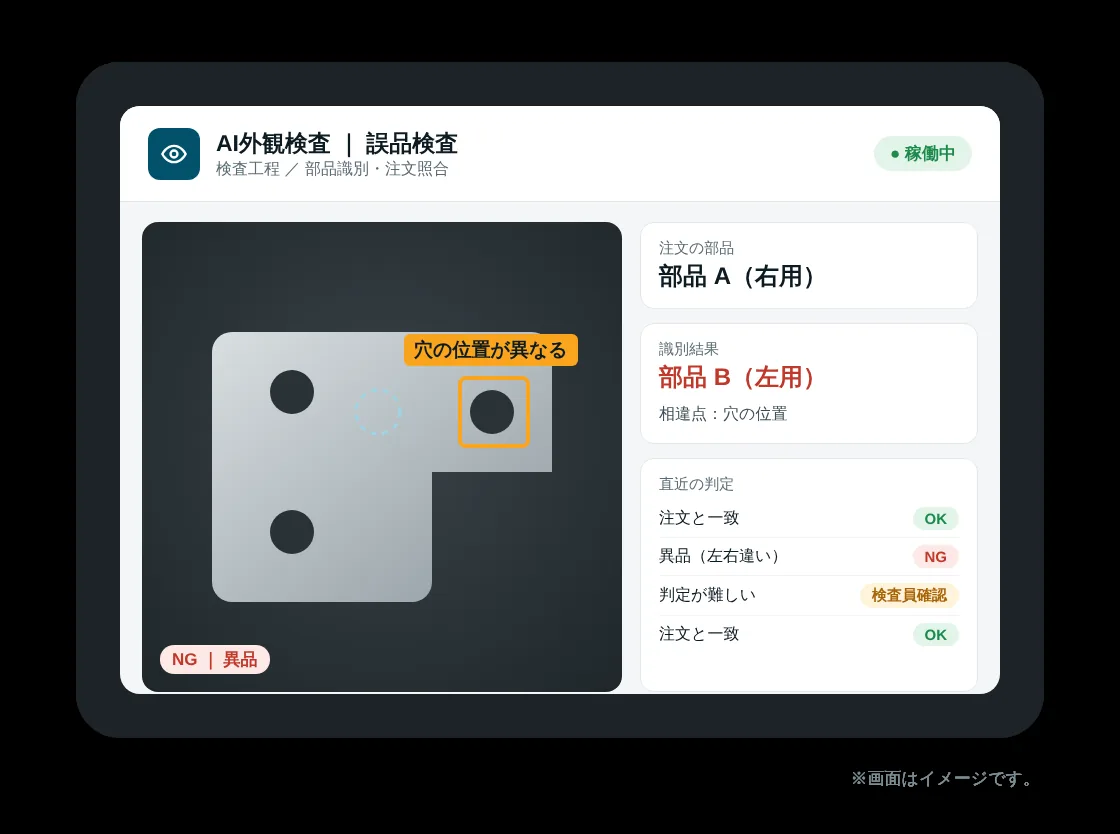
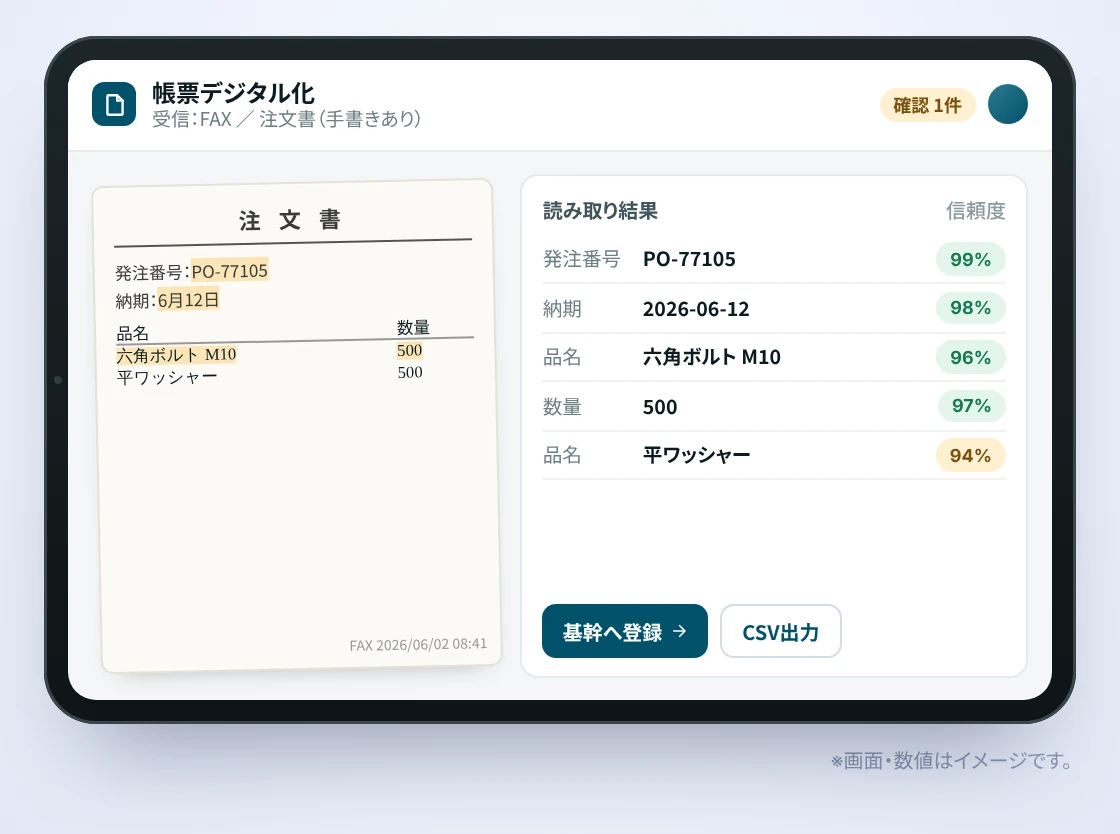
データ分析基盤が整うと、AI需要予測などの予測や、AI-OCRによる帳票データの取り込みへと活用を広げられます。データ基盤の上で、予測・検索・判定・読み取りに使っているソリューションです。

HOW WE START

データ活用の進め方

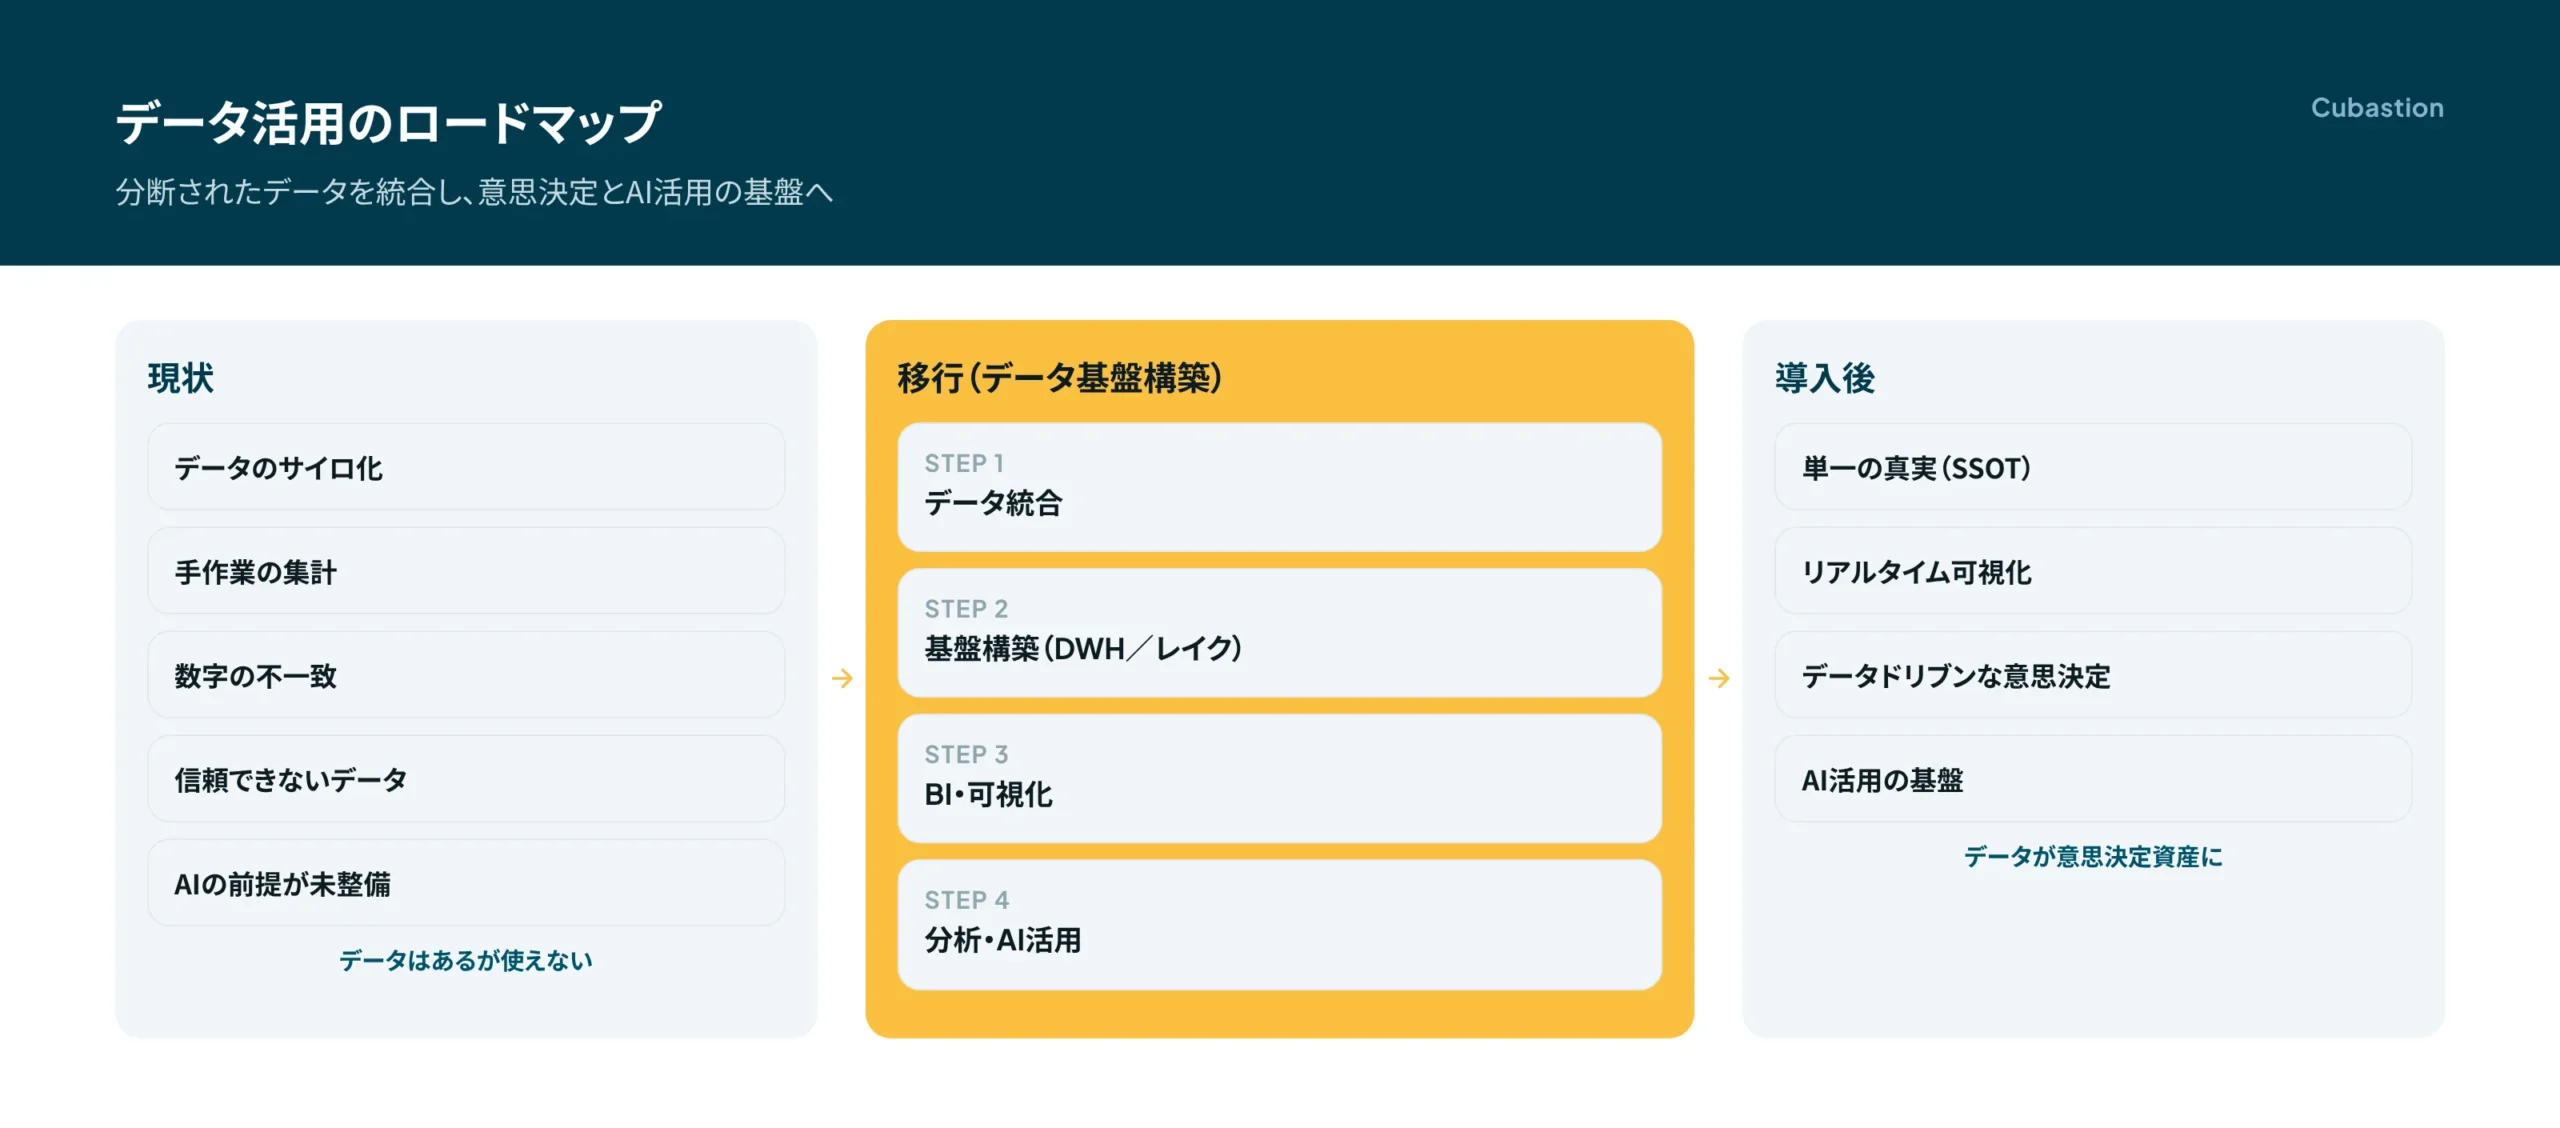
いきなり全社のデータ基盤をつくる必要はありません。現在地の把握から始めます。

STEP 1

データアセスメント

分断状況・品質・活用度を可視化し、優先順位と進め方を整理。

STEP 2

対象業務の選定

特定の業務・レポートに絞って着手範囲を決める。

STEP 3

基盤の構築

統合・品質ルール・権限を整え、BIで可視化。

STEP 4

段階的な拡大

効果を確認しながら対象を広げ、分析・予測・生成AI導入へ。

データ統合と基盤構築から始め、BI・可視化、分析・AI活用へと段階的に広げます。
FAQ

データ活用のよくある質問

データ活用は、企業でどのように進めればよいですか?

特定の業務・レポートから着手し、効果を確認しながら広げるのが基本です。データアセスメントで分断状況と品質を整理し、優先度の高い業務からデータ活用を進めます。

いいえ。データ基盤の構築は、特定の業務から段階的に進められます。将来の生成AI・予測・分析を見据え、再加工が不要な基盤として設計します。

はい。部門ごとに分散したデータサイロの解消が、データ活用の出発点です。データアセスメントで分断状況と品質を整理し、優先度の高い業務からデータ統合を進めます。

はい。特定のツールに依存せず、BIツールの導入と活用を支援します。Power BI、Tableau、Databricks、Informatica、Azure/AWSなどから、お客様の環境と目的に合わせて選びます。すでにお使いのBIツールを前提にすることもできます。

はい。AS/400を含むレガシーのデータソースを統合の対象とします。刷新もあわせて検討する場合はレガシーシステムモダナイゼーションと連携します。

レポートを無料でダウンロードする

Cubastionの個人情報保護方針については弊社Website上Privacy Policyをご覧ください。