
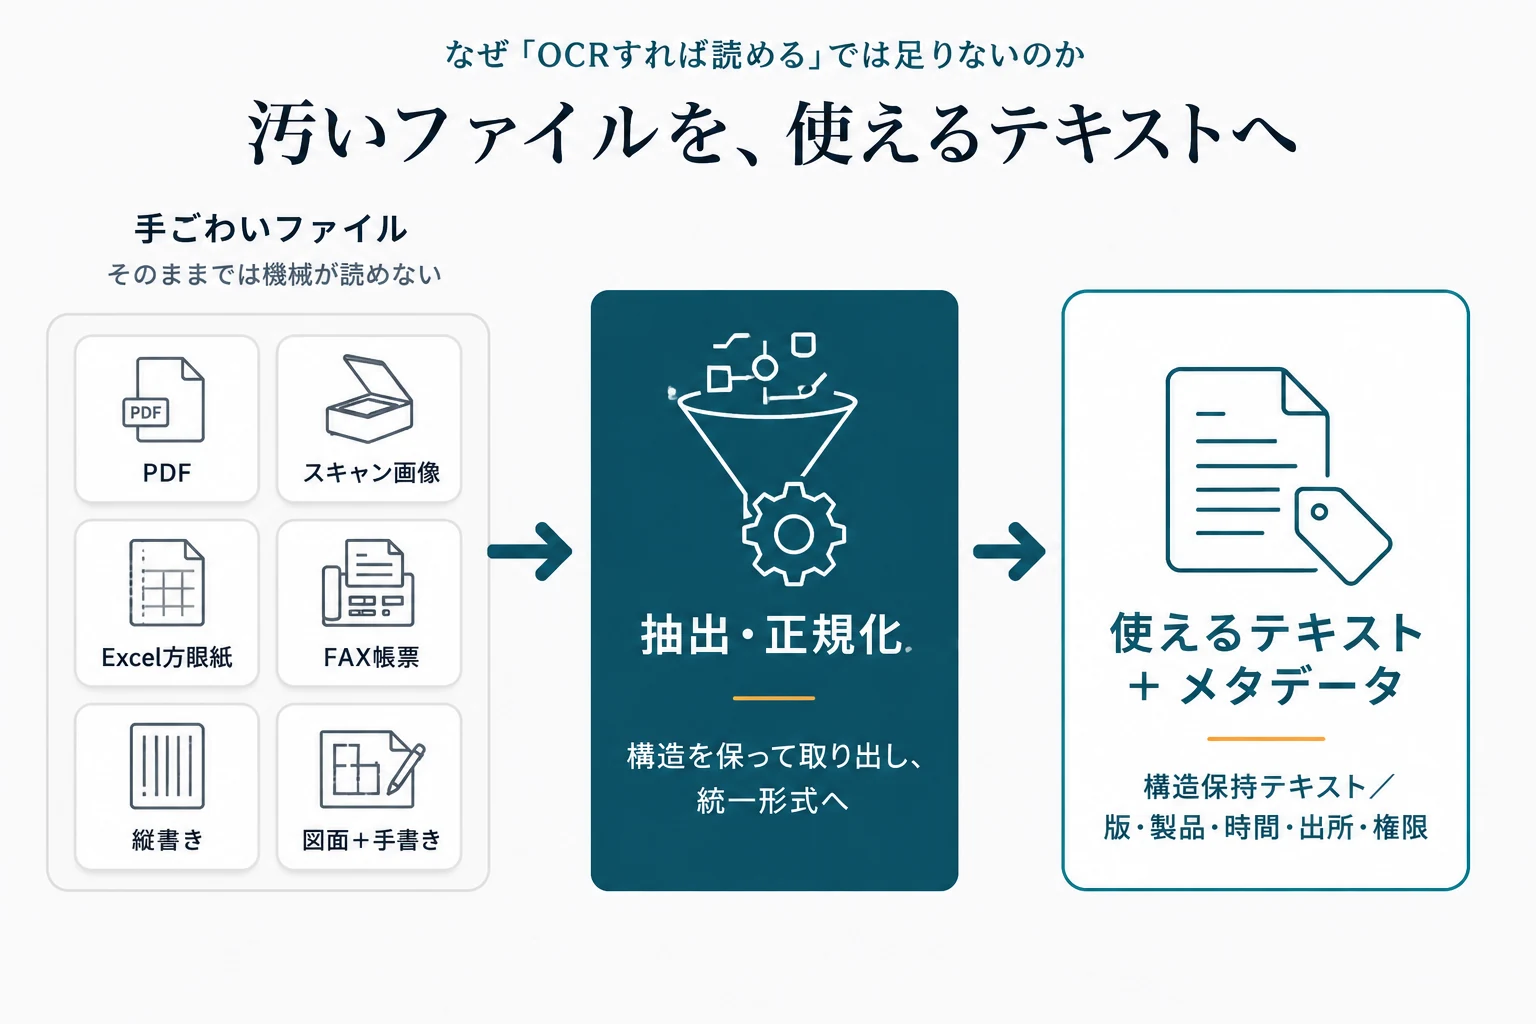
20年分のPDF・スキャン・Excelを、どこから、どうやって使える状態にするか
「OCRすれば読める」という、よくある誤解
第2回で、私たちは「検索か、構造化か」という分かれ道を見ました。どちらの道を選ぶにしても、その手前で必ず通る一区間があります。文書を、機械が使えるテキストにする——抽出と正規化です。今回は、ここに降りていきます。
多くの担当者は、こう考えます。「スキャンした書類も、OCRをかければテキストになる。あとはAIに渡すだけだ」。半分は正しく、半分は違います。
たしかに、きれいに印刷された1段組みの文書なら、OCRはよく機能します。問題は、現場の文書がそうではないことです。表が入っている。図面に注記が手書きで書かれている。縦書きと横書きが混在している。二段組みで、しかも網掛けがある。こうした文書にOCRをかけると、文字は拾えても、「どれが表で、どこが見出しで、どの数字がどの項目か」という構造が失われます。人間なら一目で分かるレイアウトの意味が、ただの文字の羅列になってしまう。
「読める」と「使える」は、違います。文字を拾うのがOCRなら、構造を保ったまま使える形にするのが、抽出・正規化という工程です。そして日本企業では、この工程が、他国よりも一段手ごわくなります。理由があります。
日本企業のファイルは、なぜ特別に手ごわいのか
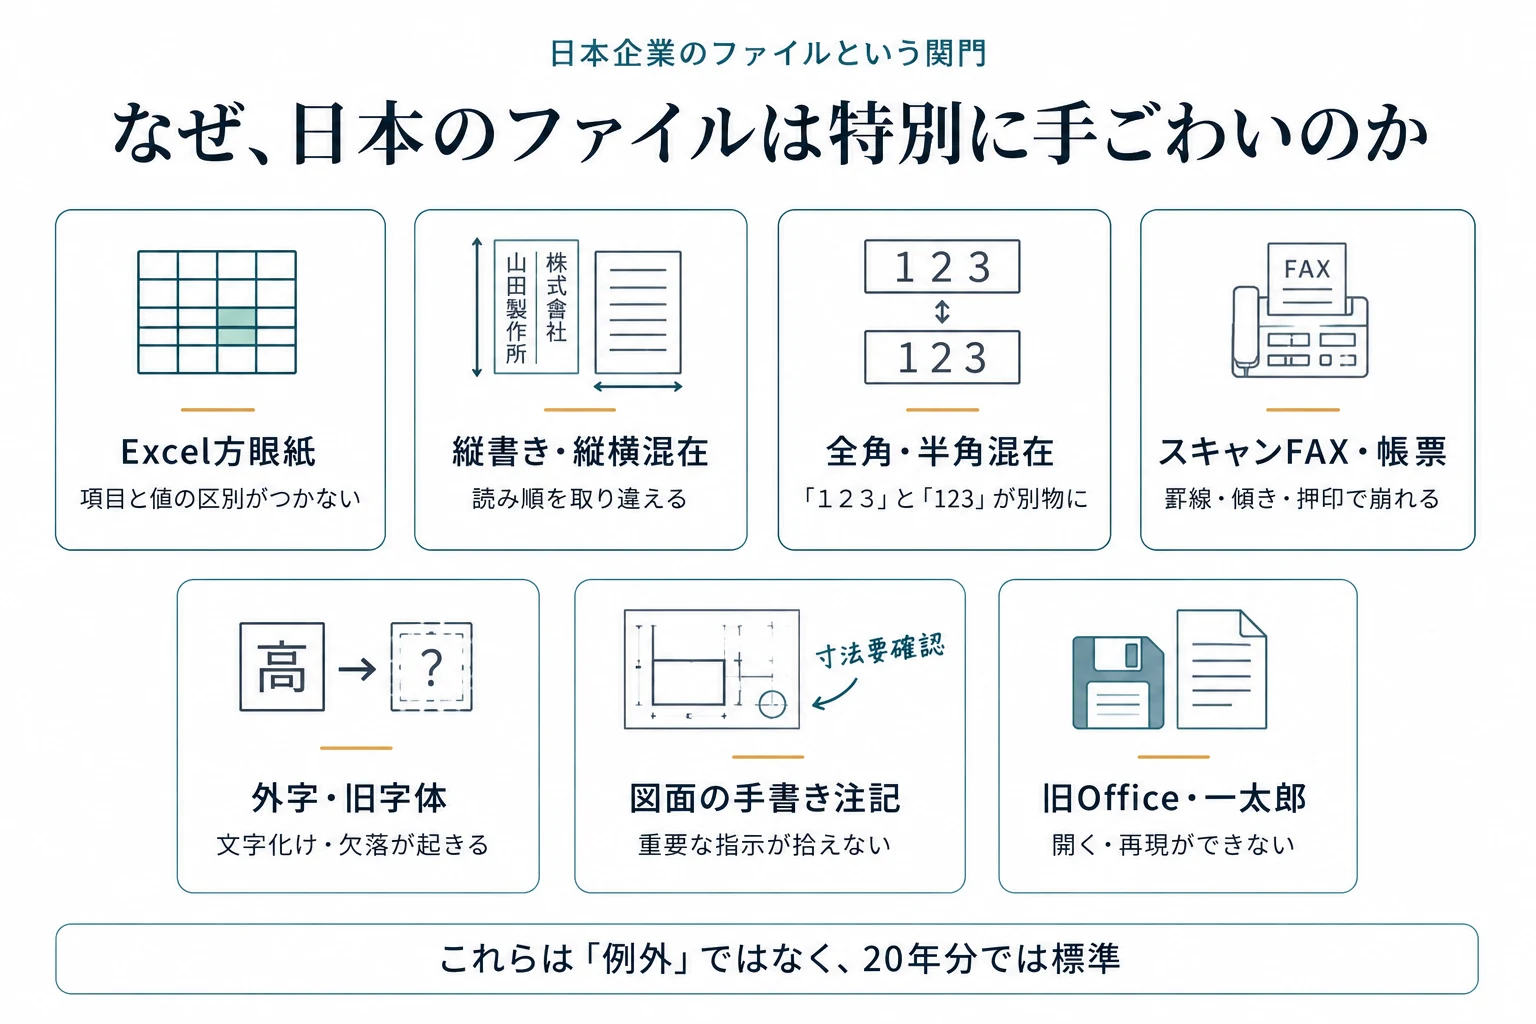
20年分の文書を抱える日本企業のリポジトリには、機械にとっての「難所」が独特の形で集まっています。代表的なものを挙げます。
- Excel方眼紙。 セルを方眼紙のように使い、レイアウトで“見た目の帳票”を作る文化。人間には読めますが、機械にとっては「どのセルが項目で、どれが値か」が判別できません。表の意味が、セル結合とスペースの中に溶けています。
- 縦書きと、縦横の混在。 縦書き、あるいは一つの文書に縦書きと横書きが同居する。素朴なOCRは読み順を取り違えます。
- 全角・半角の混在。 数字・英字・記号が全角と半角で混ざり、「123」と「123」が別物として扱われる。検索も突合も、ここでずれます。
- スキャンされたFAX・帳票。 罫線のかすれ、傾き、押印の重なり。画像として取り込まれた表は、OCRだけでは構造が戻りません。
- 機種依存文字・旧字体。 「髙」「﨑」などの外字や旧字体、丸数字・単位記号。文字化けや欠落の温床です。
- 図面の手書き注記。 設計図面のPDFに、後から手書きで加えられた修正・指示。ここに、実は最も重要な判断が書かれていることがあります。
- 古いOfficeや一太郎の形式。 開くだけで一苦労の旧フォーマット。レイアウトが再現できないものもあります。
これらは「例外」ではありません。日本企業の20年分の文書では、むしろ標準です。だからこそ、抽出・正規化を軽く見た海外製のパイプラインをそのまま持ち込むと、最初の一区間で品質が崩れます。ここを丁寧にやることが、後段すべての品質を決めます。この記事が「信頼性の関門」だと考えるゆえんです。
まず「読める」にする ― 抽出と正規化
手ごわさの正体が分かれば、対処の全体像も見えてきます。抽出・正規化は、ファイルの種類ごとに入口が違います。
- ボーンデジタル(最初からデジタル)の文書。 WordやテキストベースのPDFなど。ここは比較的素直で、レイアウトを保ったままテキスト・表・見出し構造を取り出せます。
- スキャン画像・FAX。 OCRが要りますが、鍵は「文字を拾う」ことではなく、レイアウト解析——どこが表で、どこが段落で、読み順はどうか——を伴わせることです。
- 表・帳票(Excel方眼紙を含む)。 専用の表抽出が要ります。セル結合や方眼紙レイアウトから、「項目と値」の対応を復元する。
- 画像PDF内の表・図面。 OCR+レイアウト+表抽出の合わせ技。手書き注記は、別扱いで拾う。
そして、種類が違っても出口は一つに揃えます。抽出したものを、構造(見出し・表・箇条書き・出所)を保った統一フォーマット(例:構造を保持したMarkdownやそれに準ずる中間形式)に正規化する。全角・半角、外字、表記ゆれもここで整える。バラバラのファイルを、後段が扱える一つの形に揃える——これが正規化の役割です。
ここまでで、ようやく「読める」になりました。しかし、これでもまだ「使える」には足りません。本命が残っています。
本命は、テキストではなく「メタデータ」
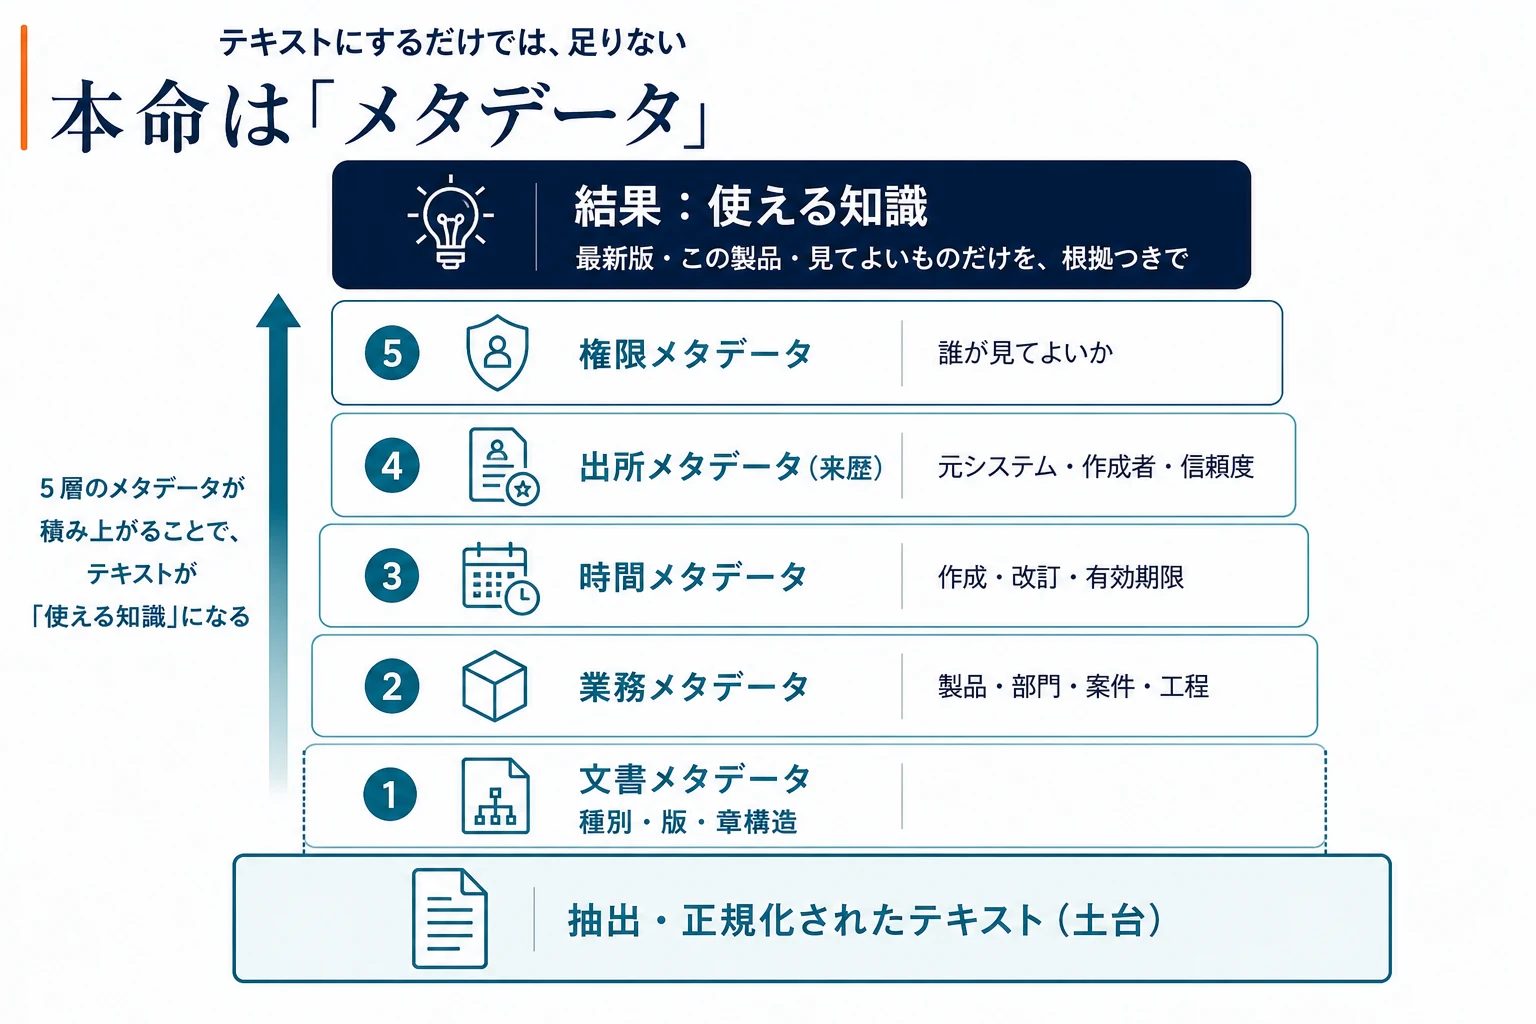
意外に聞こえるかもしれませんが、抽出したテキストそのものよりも、それに付くメタデータのほうが、実務では効くことが多いのです。
なぜか。テキストだけをAIに渡すと、AIは「似た文章」は探せても、「どの製品の、いつの、誰が承認した、最新版の文書か」を区別できません。区別できなければ、古い版を引いたり、権限のない情報を混ぜたり、別部門の同名部品と取り違えたりします。これを防ぐのが、メタデータです。実務で効く層は、およそ五つに整理できます。
- 文書メタデータ — 種別・タイトル・版・章構造。「これは規程の第3版だ」
- 業務メタデータ — 関連する製品・部門・案件・工程。「この図面は、あの製品ラインのものだ」
- 時間メタデータ — 作成・改訂・有効期限。「これは失効済みだ/これが最新だ」
- 出所メタデータ(リネージ/来歴) — 元システム・作成者・信頼度。「これはどこから来た、どれだけ信頼できる情報か」
- 権限メタデータ — 誰が見てよいか。「この人には、この文書は出さない」
この五つが揃うと、検索も回答も一変します。「最新版だけ」「この製品に関するものだけ」「自分が見てよいものだけ」を、AIが根拠つきで絞り込めるようになる。第2回で触れた「構造化」の、最初の、そして最も費用対効果の高い一歩が、実はこのメタデータです。埋め込み(ベクトル化)に凝る前に、まずメタデータを整える——多くの現場で、これが効きます。
どこから手をつけるか ― リポジトリ別の入口
とはいえ、全社の全文書を一度に、という話ではありません。順序が大切です。
まず、最も業務知識が集まっているリポジトリを一つ選びます(共有フォルダ、図面管理システム、SharePoint…)。次に、その中の文書を大まかに仕分けます——ボーンデジタルか、スキャンか、表・帳票か、混在か。仕分けができれば、どの抽出の入口が要るかが決まります。そして、サンプルで品質を測る。100件ほど抜き取り、抽出がどれだけ正しくできるかを実際に見る。ここで「思ったより読めない/思ったより読める」がはっきりします。
この地に足のついた一歩——一つのリポジトリ、サンプル100件、品質測定——が、20年分という途方もない量を、着手可能な大きさに変えます。
よくある誤解のまとめ
神話: 「OCRをかければ、文書は読める(=使える)ようになる」
現実: OCRは文字を拾いますが、表・レイアウト・縦書き・読み順は、素朴なOCRでは崩れます。日本企業のファイル(Excel方眼紙・スキャン帳票・図面の手書き注記・外字)では、なおさらです。必要なのは、文字ではなく構造を保った抽出・正規化、そしてその上に載るメタデータです。「読める」と「使える」は違います。
「理解の負債」で見ると ― アクセス負債・発見負債
第1回の言葉でいえば、この工程が返すのは、負債の最も根っこにある二つです。
- アクセス負債 — 「そもそも機械が読めない」を、「読める」に変える。
- 発見負債 — メタデータによって、「どこにあるか分からない」を、「最新版を・この製品の・見てよいものだけ、と絞って見つけられる」に変える。
全体像マップでいえば、本記事は「抽出・正規化」と「メタデータ」——土台の最初の二区間——に光を当てました。地味な工程です。しかし、ここの品質が、この先のすべて(意味処理・検索・活用)の上限を決めます。次回・第4回は、その次の一区間「意味をつくる ― チャンキングと埋め込み」に進みます。
明日から始める、三つのこと
- 一番大きいリポジトリから、100件を抜き取る。 最も業務知識が集まる文書置き場を一つ決め、100件をサンプリング。まずは現実を見ます。
- 抽出の品質を、実際に測る。 その100件で、表・レイアウト・縦書き・外字がどれだけ正しくテキスト化できるかを確認する。「OCRすれば読める」の実像が分かります。
- すでにあるメタデータを棚卸しする。 ファイル名・フォルダ構造・システムの項目に、どんなメタデータが“すでに”眠っているか。ゼロから作るより、あるものを活かすほうが速い。
土台は、派手ではありません。けれど、ここを飛ばして上に何を載せても、崩れます。第4回では、正規化されたテキストを「意味で扱える」ようにする工程へ進みます。

日本市場のプリセールスを担当。エンタープライズのデジタル変革を、構想から実装まで支援。
Cubastionは、日本企業の“手ごわいファイル”を、構造とメタデータを保ったまま使える状態にする——その最初の一区間の設計を含め、知識層づくりをお手伝いしています。
用語集(本記事で導入した言葉)
- OCR(光学文字認識) — 画像・スキャンから文字を読み取る技術。文字は拾えるが、表・レイアウト・読み順の構造は、素朴なOCRでは保持されない。
- コンテンツ抽出 — ファイルから、テキスト・表・見出し・図表などを、構造を保ったまま取り出すこと。OCRはその一部(画像→文字)にすぎない。
- 正規化 — 抽出したものを、全角・半角・表記ゆれ・外字も含めて、後段が扱える統一フォーマットに揃えること。
- メタデータ — 文書“について”の情報(種別・版・関連製品・作成日・出所・権限など)。テキスト本文と同じか、それ以上に実務で効く。
- リネージ/来歴(プロヴェナンス) — その情報が「どこから来て、誰が作り、どれだけ信頼できるか」の記録。出所メタデータの中核。