
ドキュメント・画像から、オントロジー/知識グラフへ
本稿は、エンタープライズAIの「意味の層」シリーズの併走記事です。シリーズ(第1部)では、確率論的なAIを、決定論的な業務知識(オントロジー/ナレッジグラフ)で支えるという考え方を扱いました。そこで前提にしていた——けれど詳しくは述べていなかった——のが、「構造化データと非構造化データを、どう結ぶのか」という問いです。本稿は、その技術的な道筋を掘り下げます。
価値の多くは、非構造化の中にある
業務の意思決定に効く情報の多くは、整然としたデータベースの外にあります。クレームの自由記述、契約書、技術マニュアル、メール、点検レポート、そして画像——損傷写真、部品の画像、図面、スキャンされた帳票。これらは「非構造化データ」と呼ばれます。
一方、基幹システムが持つのは「構造化データ」——行と列に整理された、取引やマスタの記録です。問題は、価値ある非構造化データと、信頼できる構造化データが、別々の世界に分かれていることです。そして現場の問いは、しばしば両方にまたがります。
二つのストリームと、その非対称性
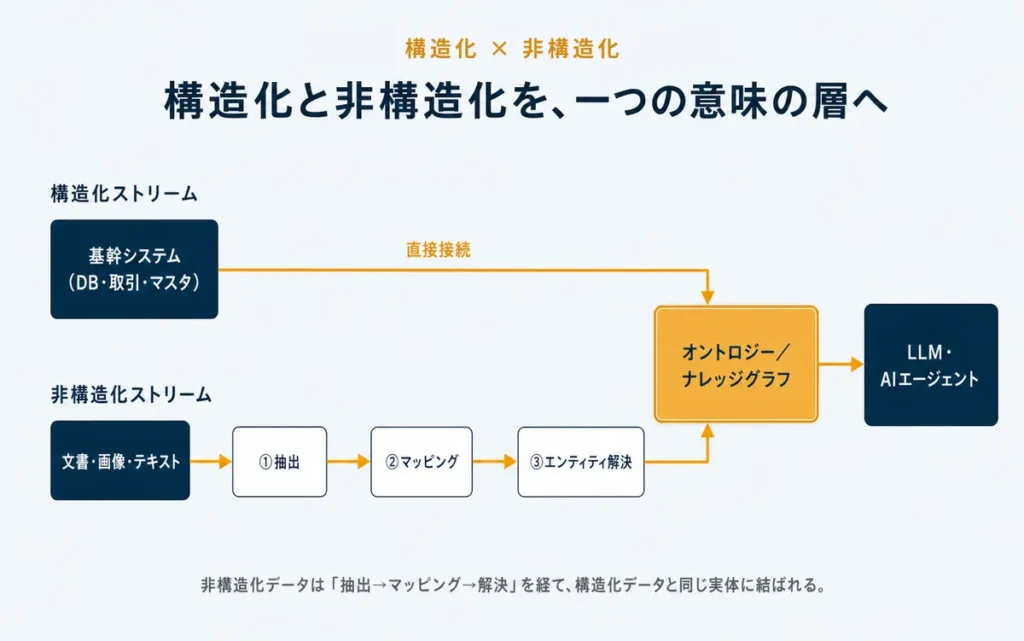
第1部で触れたとおり、企業のデータは構造化・非構造化の二つのストリームとして並行して流れています。ただし、両者の扱いには非対称性があります。
構造化データは、すでに「意味」を持っています。VINは車両を、顧客IDは顧客を指す——だから、オントロジーの実体としてほぼそのまま接続できます。一方、非構造化データは、人間には読めても、機械にとっては「意味」が明示されていません。そこから業務上の意味を取り出す工程が必要になります。
その工程は、大きく三段階です。抽出 → マッピング → エンティティ解決。順に見ていきます。
ステップ1 ― 非構造化から「意味」を取り出す(抽出)
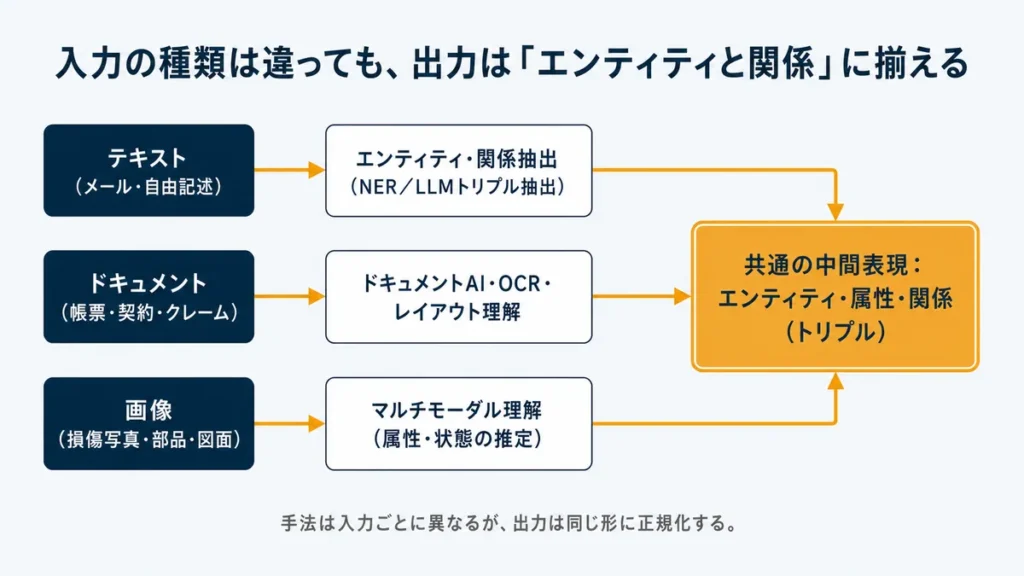
抽出の手法は、入力の種類によって異なります。
テキスト(メール・自由記述)。 固有表現抽出(NER)でエンティティ(人・組織・製品・部品など)を取り出し、関係抽出やLLMによって「主語・述語・目的語」のトリプルを起こします。たとえば「カローラの保証クレーム」という一文から、(クレーム, 対象, 車両) (車両, 種別, カローラ) といった構造を取り出す。これは、第1部で触れたGraphRAG(テキストからグラフを起こす手法)と同じ発想です。
ドキュメント(帳票・契約・クレーム票)。 単なるOCR(文字起こし)では足りません。ドキュメントAIは、レイアウトを理解し、キーと値、表、項目の対応関係まで構造として取り出します。Cubastionが用いるAzure Document Intelligence(Form Recognizer)はこの領域の技術で、スキャンPDFや手書きを含む帳票から、フィールド単位でデータを抽出します。
画像(損傷写真・部品・図面)。 マルチモーダルのモデルが、画像から属性や状態を推定します。たとえば損傷部位の特定、部品種別の判別、図面からの記号の読み取りなど。ただし画像は、テキストや帳票よりも誤りやすい領域です。だからこそ、後述する信頼度と検証が、ことさら重要になります。
入力の種類ごとに手法は違っても、出力は共通の中間表現——エンティティ・属性・関係(トリプル)——に揃えます。これが、次の工程の入口です。
ステップ2 ― オントロジーという「受け皿」にマッピング
抽出した生のエンティティや属性は、まだ表記の揺れを抱えています。「保証」「ワランティ」「Warranty」が、別物として出てくる。ここで効くのが、オントロジー(定義済みのスキーマ)を受け皿にすることです。
抽出された語を、オントロジーが定義する正規の概念(クラス)とプロパティに対応づけます。同義語や表記揺れを、一つの正規概念に寄せる。こうして、どの入力源から来たデータも、同じ「意味」の上に揃います。受け皿となるスキーマがあるからこそ、雑多な抽出結果が、一貫した知識として積み上がっていきます。
ステップ3 ― 構造化データと「結ぶ」=エンティティ解決
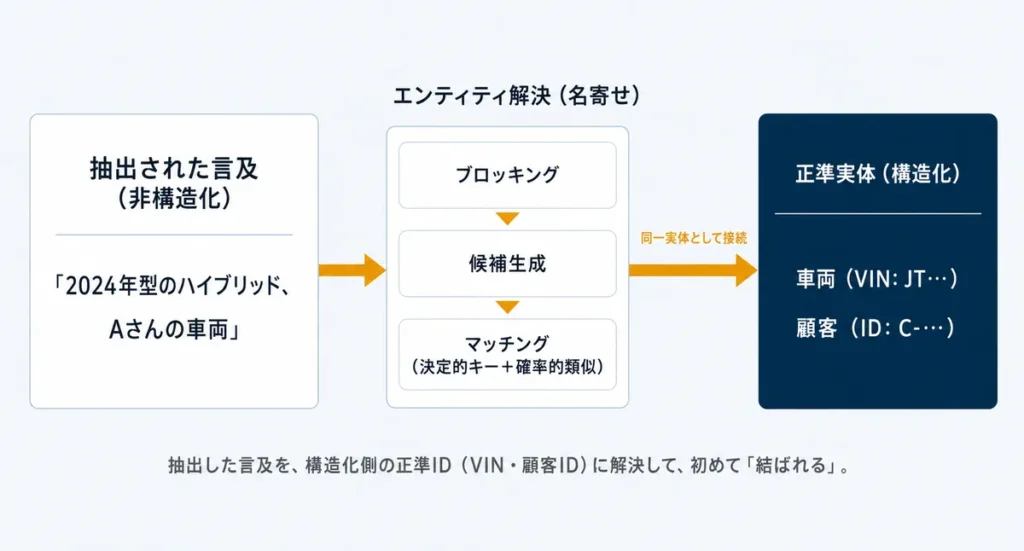
ここが、本稿の核心です。非構造化から取り出したエンティティを、構造化側の正準ID(VIN、顧客ID、部品番号)に解決して、同一の実体に束ねる——この工程をエンティティ解決(名寄せ/レコードリンケージ)と呼びます。これが、「結ぶ」の正体です。
手順は、おおむね次のように進みます。
- ブロッキング: 比較対象を絞り込む(全件同士を突き合わせない)。
- 候補生成: 似ている可能性のあるペアを挙げる。
- マッチング: 決定的キー(VINの完全一致など)と、確率的な類似(氏名・住所の表記揺れを許容した照合)を組み合わせて、同一性を判定する。
- マージ/信頼度: 同一と判定したものを束ね、曖昧なものは信頼度付きで保留し、人手の確認に回す。
この工程を経て、文書から取り出した「あるクレーム」が、構造化側に実在する車両・顧客・部品に接続されます。ここで初めて、非構造化と構造化が一つのグラフになります。抽出やマッピングだけでは、まだ「結ばれて」いません。正準IDへの解決があって、はじめて両者は同じ実体を指すようになります。
アーキテクチャとして見る
全体像は、二つのストリームが一つの意味の層に合流する形になります。
- 構造化ストリーム: 基幹システムのデータを、ほぼそのまま実体として接続。
- 非構造化ストリーム: 文書・画像・テキストを、抽出 → マッピング → エンティティ解決を経て接続。
- 両者が、オントロジー/ナレッジグラフの上で同じ実体に結ばれ、その上でLLM・AIエージェントが推論する。
つまり、データ → AI でも データ → オントロジー → AI でもなく、非構造化については データ → 抽出 → マッピング → 解決 → オントロジー → AI という、もう一段の工程が挟まります。
実装の現実 ― 抽出は完璧ではない
率直に言えば、抽出は完璧にはなりません。特に画像や手書き、品質の悪いスキャンでは、誤りが避けられません。だからこそ、誤った抽出を、そのままグラフに入れない仕組みが要ります。
- 信頼度スコア: 抽出・解決の各段階に確からしさを持たせ、低いものは保留する。
- ヒューマン・イン・ザ・ループ: 曖昧なものは人が確認する経路を用意する。
- 出典トレース: グラフ上の各事実に、それが「どの文書の・どの箇所から来たか」を必ず持たせる。これは、第1部・シリーズで一貫して重視してきた、説明可能性と監査可能性の土台です。
- ガバナンス/プライバシー: 文書や画像には機微情報が含まれます。何を取り込み、何を取り込まないかを、設計の段階で決める。
そして、ここでもシリーズと同じ原則が効きます。すべてを一度にやらない。一つのユースケースに範囲を絞り、そこで必要な入力源と抽出だけを、検証可能な形で組み込む。
Cubastionの実装
Cubastionは、この「結ぶ」工程を、実際のエンタープライズ環境で実装しています。ドキュメントAI・OCR(Azure Document Intelligence/Form Recognizer)による帳票・文書の構造化、Engineering.IAに見られる構造化フィルタとセマンティック検索のハイブリッド、そしてAI-CMSによる技術文書・部品情報のライフサイクル管理——いずれも、非構造化と構造化を同じ意味の上に束ねるための部品です。
まとめ ― 「結ぶ」は、魔法ではなく工程
非構造化データと構造化データを結ぶことは、魔法ではありません。抽出・マッピング・エンティティ解決という、再現可能な工程です。そして、その全工程の「受け皿」になるのが、オントロジーという意味の層です。
文書や画像の中に眠っていた情報が、基幹システムの実体と同じグラフ上で結ばれたとき——AIは、ようやく企業の知識の「全体」を相手に推論できるようになります。意味の層が効くのは、構造化データだけではありません。むしろ、これまで活かしきれなかった非構造化データを取り込めることにこそ、その真価があります。
「意味の層」という考え方の全体像は、シリーズ第1部にまとめています。自社のどのデータを、どう結ぶと効くのかを整理したい方は、AI・生成AIサービスもあわせてご覧ください。