
なぜ、社内検索は「当たり前の答え」を外すのか
なぜ、社内検索は「当たり前の答え」を外すのか
社内AIや検索を入れたのに、「なぜこんな当たり前の答えを外すのか」という場面に出会う——多くの企業が経験します。原因の多くは、検索の「作り方」にあります。
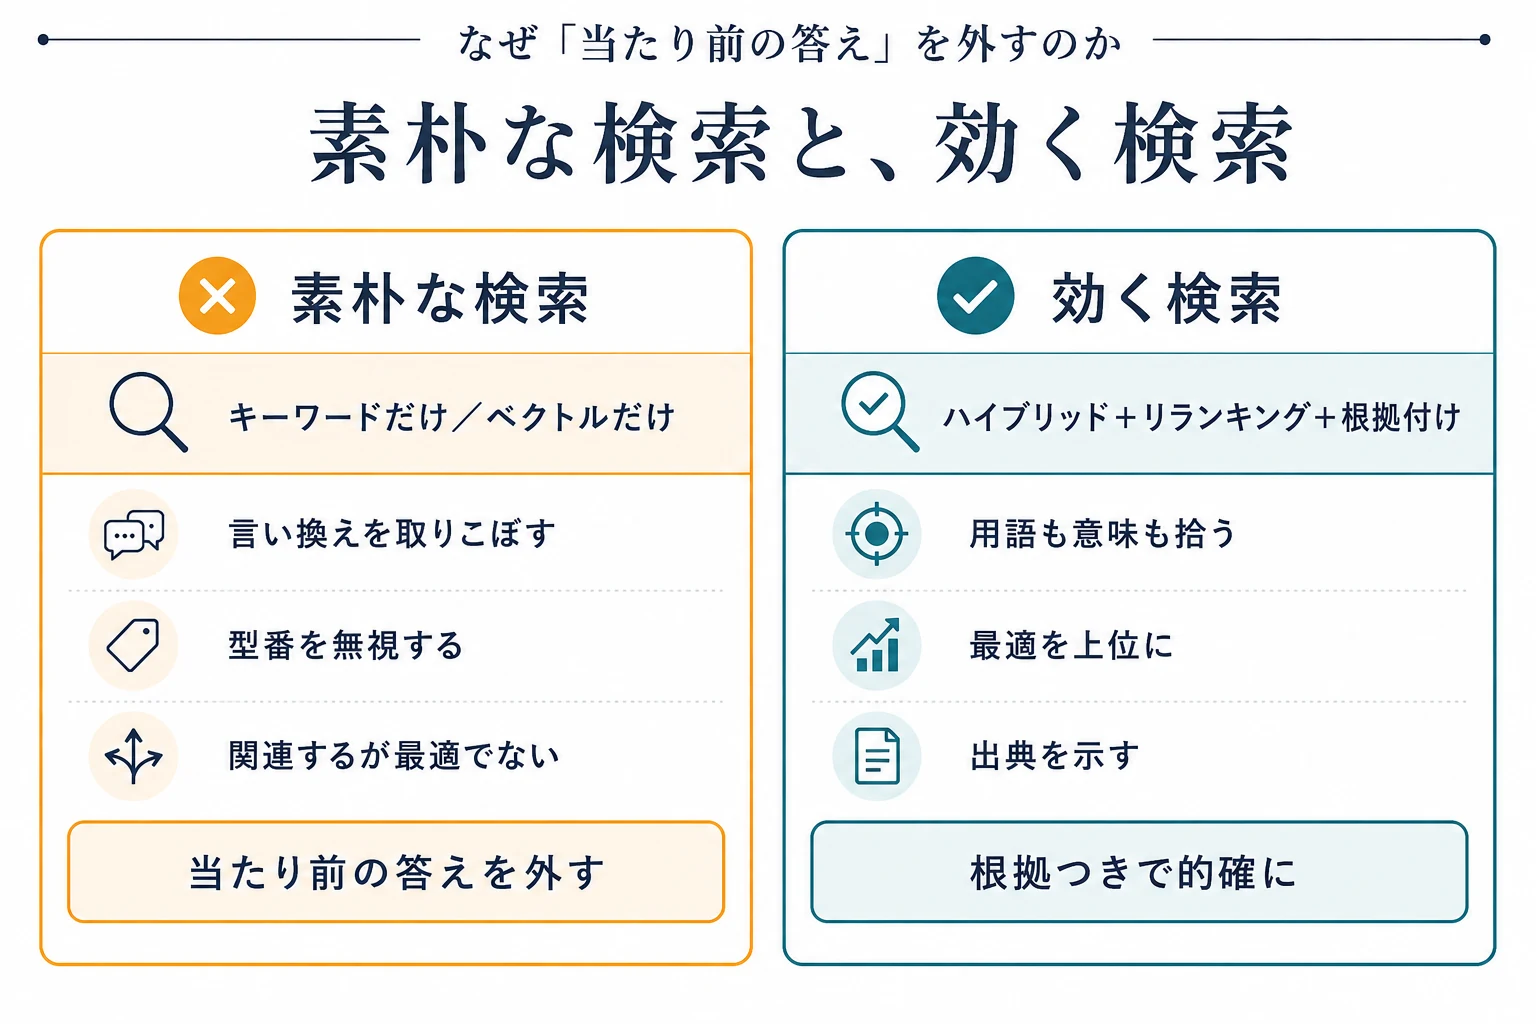
第4回で見たように、ベクトル検索は「表現の近さ」を測るのであって、意味を理解しているわけではありません。だから、ベクトル検索だけに頼ると、型番やコードのような”正確な一致”が要る問いを取りこぼし、逆にキーワード検索だけに頼ると、言い換え(「熱に強い」「高温耐性」)を拾えません。さらに、関連する文書は出てくるのに、最も適切なものが上位に来ない。出典が示せないから、答えを信じてよいか分からない。
つまり、”効く検索”は一つの道具ではできません。問いの型に合わせて、複数の道具を組み合わせる——これが、精度の壁を越える鍵です。この記事では、その組み立て方を整理します。
検索の道具は、一つではない ― キーワード・ベクトル・ハイブリッド
まず、基本の三つを押さえます。
- キーワード検索(全文検索)。 文字列の一致で探す。型番・コード・固有名・正確な用語に強い。「熱に強い」で「耐熱」を拾えないなど、言い換えには弱い。
- ベクトル検索(意味検索)。 第4回の埋め込みを使い、言い回しが違っても近い意味を拾う。ただし、正確な一致(型番など)はむしろ苦手で、「似ているが違う」を上位に出すこともある。
- ハイブリッド検索。 上の二つを組み合わせて、両方の長所を取る。キーワードで”正確さ”を、ベクトルで”意味”を拾い、スコアを統合する。
現場の文書は、正確な用語と、ばらついた言い回しが混在しています。だから多くの場合、ハイブリッドが実務の既定値になります。特別な構成ではなく、”普通に効く”組み方です。
取りこぼしを減らす ― リランキングと根拠付け
ハイブリッドで候補を集めたら、次に効くのが二つの仕上げです。
リランキング(再ランク付け)。 検索は関連候補を集めますが、「最も適切な順」に並んでいるとは限りません。リランキングは、集めた上位候補をもう一段、賢く並べ直す工程です。「関連はするが最適でない」を上に出してしまう問題を、ここで抑えます。多くの現場で、費用対効果の高い一手になります。
根拠付け(グラウンディング)と引用。 答えを、社内の実際の情報源に結びつけ、出典を示せる状態にする。これがあると、利用者は答えを確かめられ、信頼できます。さらに、必要な情報源を漏れなく引けているか(引用の網羅性)も、実務では重要な品質です。第3回のメタデータ(版・権限・出所)が、ここで効いてきます——「最新版だけ」「見てよいものだけ」を根拠として絞れるからです。
関係をたどる検索 ― GraphRAG
ここまでは「似た文章を、正確に・適切に・根拠つきで集める」話でした。しかし第2回で見たように、答えが「文章と文章の関係の中」にある問い——「この規格を変えると、どの部品に影響するか」——には、これだけでは届きません。
そこで登場するのが GraphRAG です。検索に、知識グラフ(関係の地図)を組み合わせる。関係をたどって関連する要素を集め、その上でテキストを検索する。検索の速さと、構造の”関係をたどる力”を両立させる考え方です。第2回で「構造化」、第4回で「固有表現(エンティティ)」と述べてきた線が、ここでつながります。
よくある誤解:「ハイブリッド検索は複雑すぎて過剰」
神話: 「ハイブリッド検索やリランキングは複雑すぎる。ベクトル検索(RAG)だけで十分だ」
現実: いま、ハイブリッド検索とリランキングは、特別な作り込みではなく、実務の標準的な選択肢になっています。むしろ過剰なのは、一つの方法にすべてを背負わせること——ベクトルだけ、あるいはキーワードだけで全問いに答えさせようとする構成です。多くの場合、ハイブリッド+リランキング+根拠付けが、最も費用対効果の高い精度改善になります。
判断の目安:どの検索を、いつ使うか
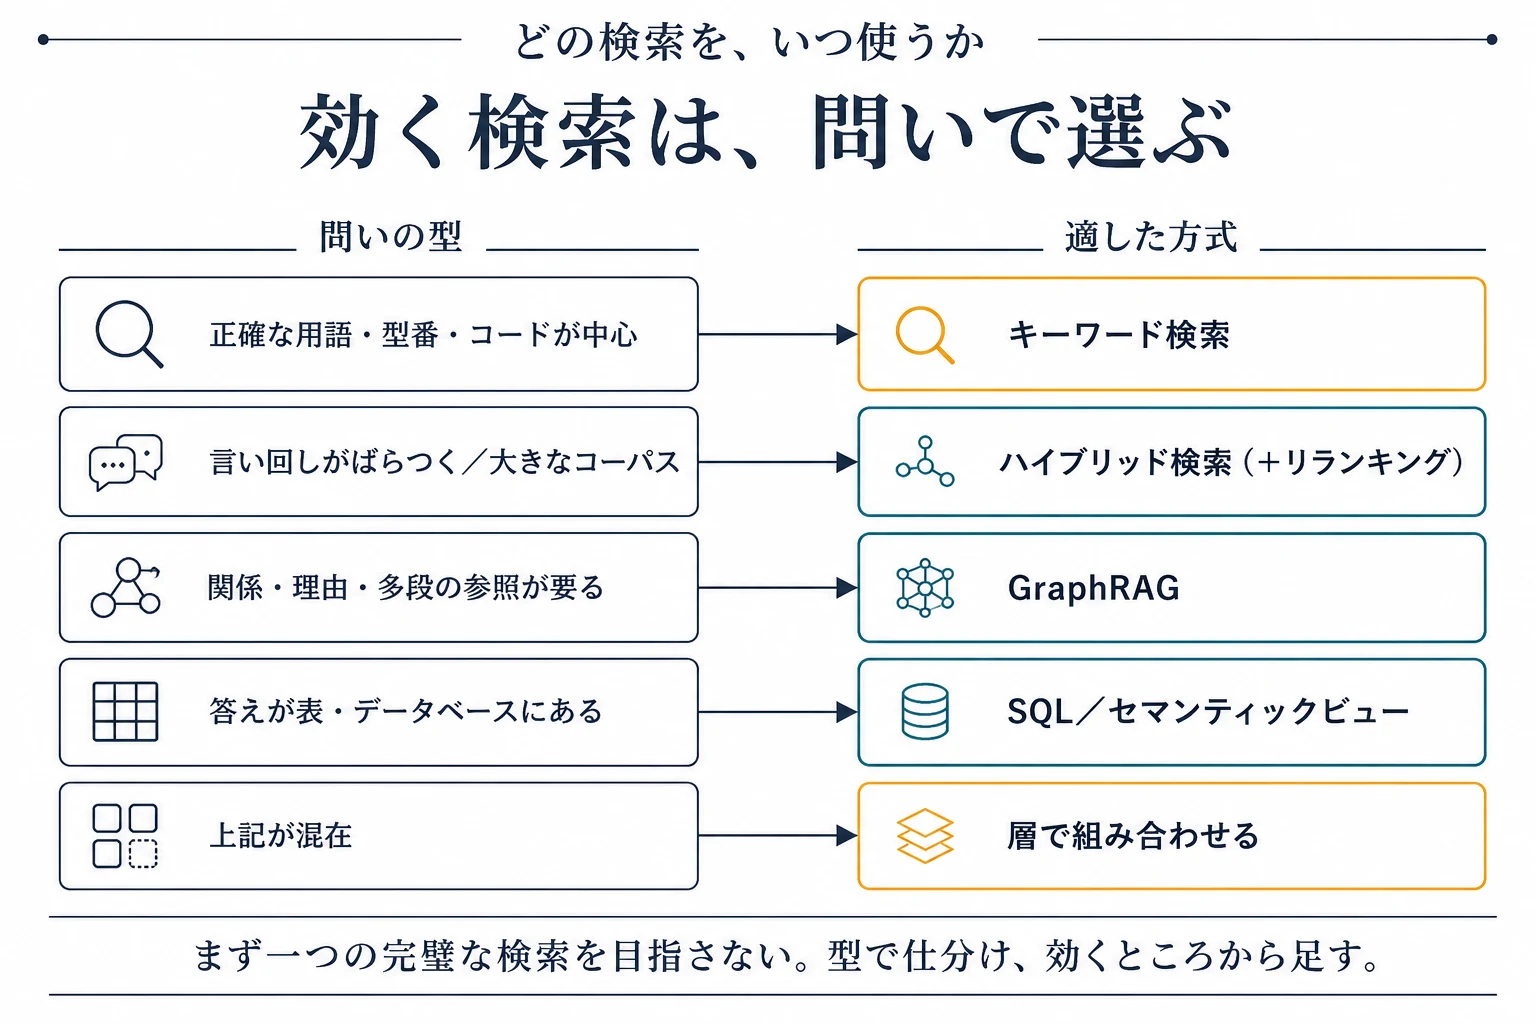
問いの型に合わせて、道具を選びます。多くの現実の社内検索は、これらを”層”にして組み合わせます。
- 正確な用語・型番・コードが中心 → キーワード検索
- 言い回しがばらつく/大きなコーパス → ハイブリッド検索(+リランキング)
- 関係・理由・多段の参照が要る → GraphRAG
- 答えが表・データベースにある → SQL/セマンティックビュー
- 上記が混在 → 層で組み合わせる
「まず一つの完璧な検索」を目指す必要はありません。主要な問いを型で仕分け、効くところから足していく——これが現実的な順序です。
「理解の負債」で見ると ― 検索負債の下流
第1回の言葉でいえば、本記事が返すのは、検索負債の”下流”です。第4回で「意味で探せる材料」を整え、本記事でその材料を使って“実際に効く検索”を組む。キーワードで正確さを、ベクトルで意味を、リランキングで最適さを、そして根拠付けで信頼を——。
`[現在地・任意:全体像マップで「検索」をアンバー強調(A2_2を流用)。主図2点には含めない。]`
これで、土台から検索までの一本の線がつながりました。次回・第6回は「ナレッジグラフと『意味の層』」——GraphRAGの土台であり、関係を扱う”意味の層”そのものに、さらに深く降りていきます。
明日から始める、三つのこと
- 検索ログを取り出す。 実際に何が検索され、何が「ゼロ件」や「答えられなかった」になっているかを見る。改善の的が、ここで分かります。
- 答えられなかった問いを、型で仕分ける。 型番一致か、言い換えか、関係か、集計か。型が分かれば、足すべき道具(キーワード/ハイブリッド/GraphRAG/SQL)が決まります。
- 20問で、キーワード対ハイブリッドを比べる。 現場の実際の問いを20問選び、素朴な検索と、ハイブリッド+リランキングを比較する。多くの場合、ここで手応えが出ます。
次回・第6回では、この GraphRAG の土台——ナレッジグラフと「意味の層」——に入ります。

日本市場のプリセールスを担当。エンタープライズのデジタル変革を、構想から実装まで支援。
Cubastionは、キーワード・ベクトル・ハイブリッド・GraphRAGの使い分けと、リランキング・根拠付けの設計——”効く検索”の組み立てを、日本語の実情に合わせてお手伝いしています。
用語集(本記事で導入した言葉)
- ハイブリッド検索 — キーワード検索(正確な一致)とベクトル検索(意味の近さ)を組み合わせ、両方の長所を取る検索方式。多くの社内検索の実務的な既定値。
- リランキング(再ランク付け) — 検索で集めた上位候補を、もう一段賢く並べ直す工程。「関連はするが最適でない」を上位に出す問題を抑える。
- GraphRAG — 検索(RAG)に知識グラフ(関係の地図)を組み合わせ、関係をたどりながら答えを集める考え方。関係・多段の参照を要する問いに効く。
- 根拠付け(グラウンディング) — 回答を社内の実際の情報源に結びつけ、出典を示せる状態にすること。利用者が答えを確かめられ、信頼できる。
- 引用網羅性 — 答えるために必要な情報源を、漏れなく引けているか。抜けがあると、正しく見えて不完全な答えになる。